 400-6666-582
 更多产品








TextIn文档解析Tips
欢迎各位开发者试用TextIn出品的通用文档解析产品,以下的内容可能会帮助您更快更好地完成产品集成。当然,如果有更多的问题,也可以随时在群里找我们哦~
一、接口调用
1.1 SampleCode
为方便大家快速调用接口,我们准备了几个版本的samplecode。使用时只需要将TextIn平台的 【app-id】、【secret-code】, 以及 【文件名】 替换掉即可
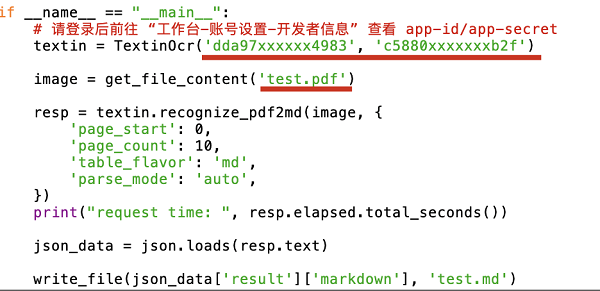
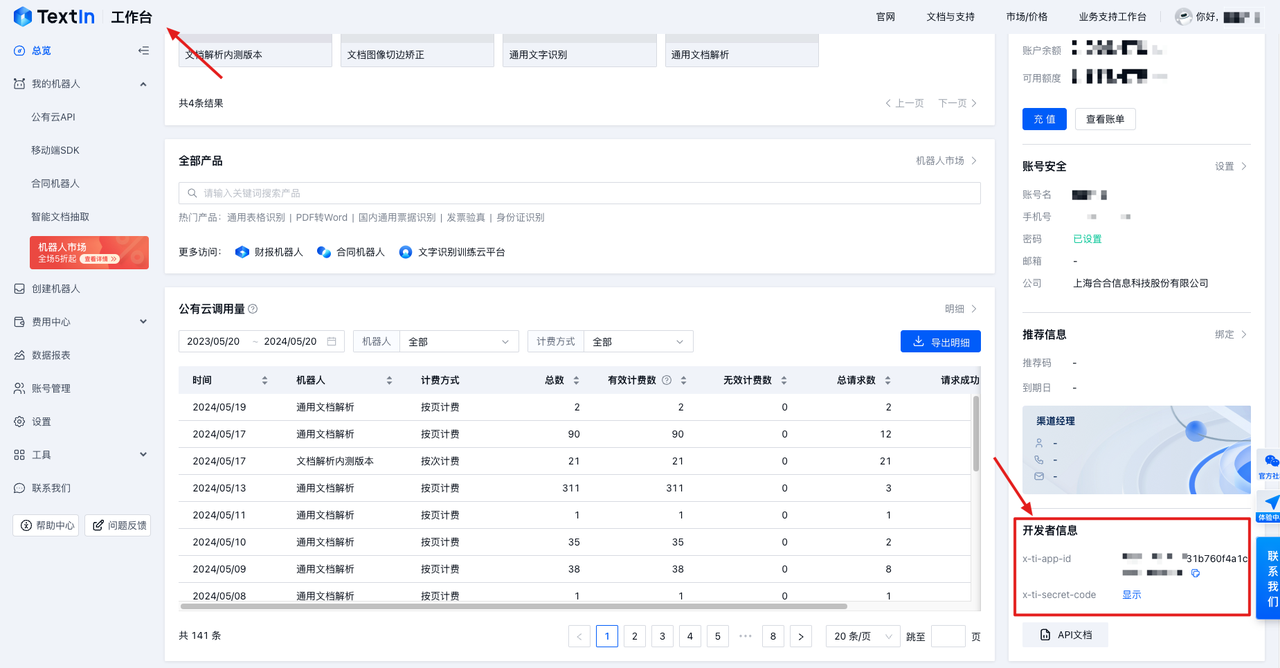
app-id和secret-code在TextIn-工作台可查看 (https://www.textin.com/console/dashboard/overview) ,如下:
Sample文件(python、java、js、go)点击下方文件即可获取,如有更多语言或功能的需求,欢迎联系告诉我们。
1.2 请求api时,自定义配置参数
以启用markdown_details输出为例,可以直接修改接口地址,也可通过request函数的params来设置。(以下均为python代码)
1)直接修改接口地址
# 定义接口地址和参数
url = 'https://api.textin.com/ai/service/v1/pdf_to_markdown'
para = 'markdown_details=1'

# 重写url
url = url + '?' + para

# 再直接用后续代码请求即可
2)使用params参数
# 定义接口地址和参数
url = 'https://api.textin.com/ai/service/v1/pdf_to_markdown'
params = {
    'markdown_details': 0  # 设置为0,表示返回简洁版的Markdown格式
    }

# 设置requests调用方式
response = requests.post(url, params=params)
1.3 将输出结果中的表格单独提出来
1)把html形式的表格导出为excel
2)获取md格式的表格结果
| 语言 | python | java |
|---|---|---|
| sample文件 | pdf_to_md_table | pdf_to_md_table |
|
1.4 使用切边矫正增强进行图片预处理,提升文档解析的识别效果
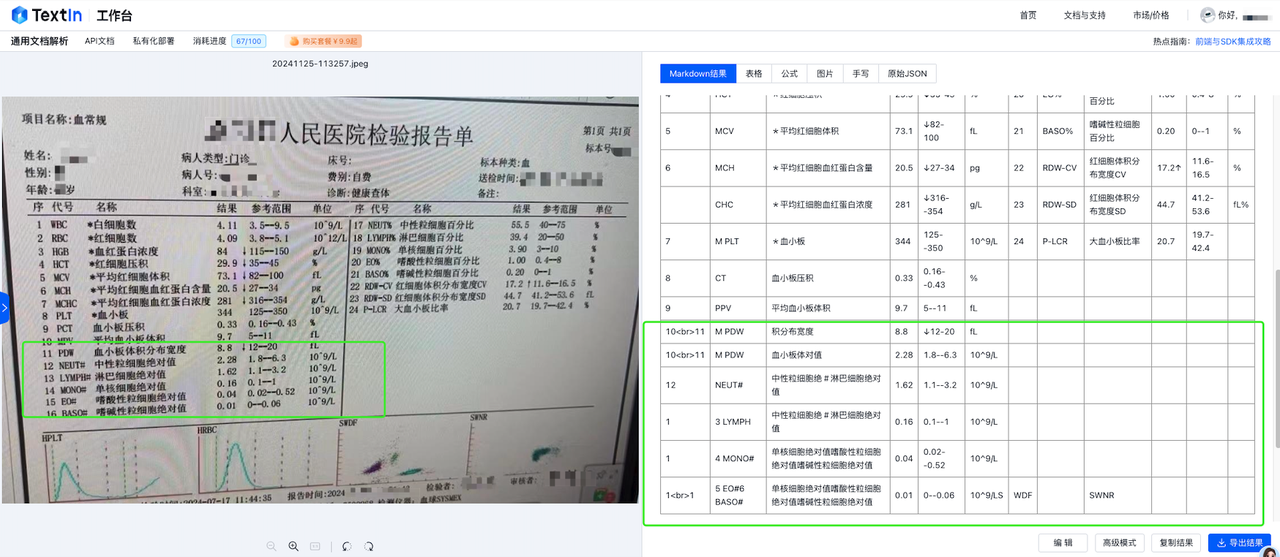
有用户和我们反馈,像上面这样的样本,使用通用文档解析的识别效果都不行,乱成一团了。
其实呢,目前通用文档解析在设计时,主要是为了处理标准格式文档的。而像这种文字都有倾斜的图片,一般是需要做一些预处理,才能有较好的效果。TextIn平台上,有一款文档图像切边增强(https://www.textin.com/market/detail/crop_enhance_image) 的产品,就能很好地承担这个预处理任务。效果如下:
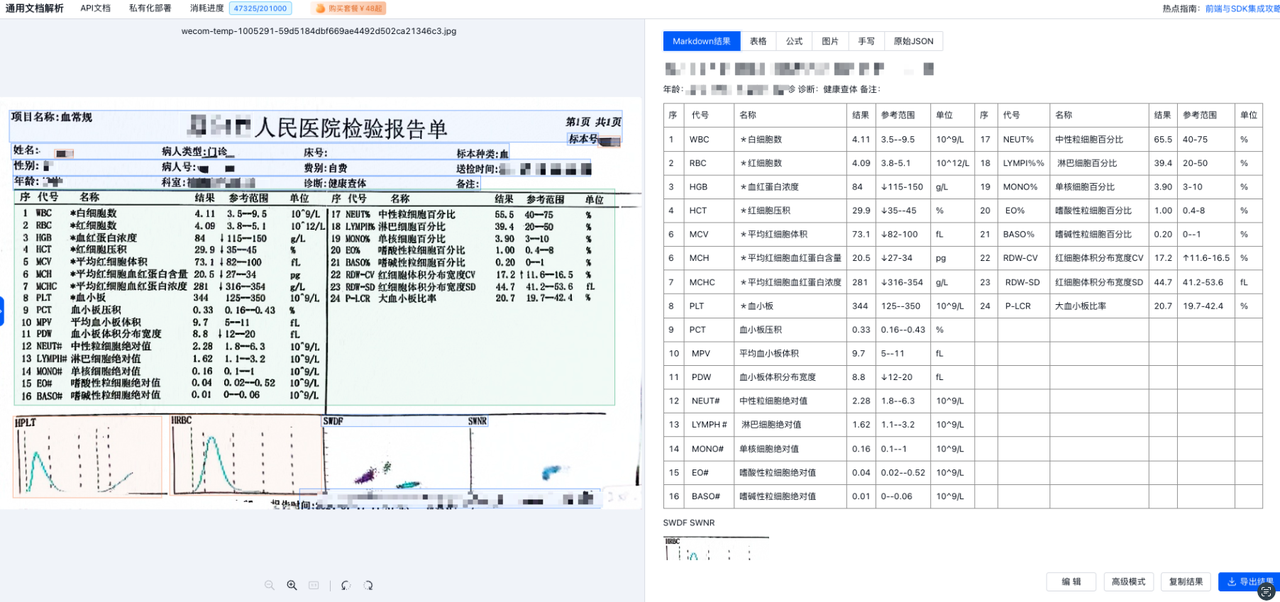
可以看到,原来处理不好,混在一团的表格,在做完图片的预处理之后,明显就清晰多了。
我们也快速写了一个简单的接口调用代码,方便开发者们直接使用。基本逻辑就是:
- 先用切边增强的接口完成一遍图片预处理,拿到返回的base64字符串
- 将base64字符串保存为图片二进制流
- 传入图片二进制流,调用文档解析接口进行表格识别
import json
import base64
import requests
import os

class CommonOcr:
    def __init__(self, img_data):
        # 请登录后前往 “工作台-账号设置-开发者信息” 查看 x-ti-app-id
        self._app_id = 'dda97xxxxx4983'
        self._secret_code = 'c588xxxx5b2f'
        self._img_data = img_data

    def pdf_to_markdown(self):
        # pdf转markdown
        url = 'https://api.textin.com/ai/service/v1/pdf_to_markdown?table_flavor=md'
        head = {
            'x-ti-app-id': self._app_id,
            'x-ti-secret-code': self._secret_code
        }
        try:
            result = requests.post(url, data=self._img_data, headers=head)
            return result.text
        except Exception as e:
            return str(e)

    def crop_enhance_image(self):
        # 图片切边矫正增强
        url = 'https://api.textin.com/ai/service/v1/crop_enhance_image'
        head = {
            'x-ti-app-id': self._app_id,
            'x-ti-secret-code': self._secret_code
        }
        try:
            result = requests.post(url, data=self._img_data, headers=head)
            return result.text
        except Exception as e:
            return str(e)

def simple_test(filePath):
    # 读取图像并转换为二进制数据
    with open(filePath, 'rb') as file:
        img_data = file.read()

    response = CommonOcr(img_data)

    # 获取并解码图像
    image_base64 = json.loads(response.crop_enhance_image())['result']['image_list'][0]['image']
    image_data = base64.b64decode(image_base64)

    # 直接将解码后的图像数据传入识别方法
    response = CommonOcr(image_data)
    parse_result = json.loads(response.pdf_to_markdown())

    # 输出markdown结果
    print(parse_result['result']['markdown'])

if __name__ == "__main__":
    simple_test('test.png')
二、平台使用
2.1 查看产品用量
- 登录官网后,在任何有【工作台】按钮的地方,点击并进入工作台
- 找到想要查看的产品,鼠标悬浮上去后,点击【查看详情】,进入单个产品的数据面板
- 如果关注【通用文档解析】的余量,可以直接访问:https://www.textin.com/console/dashboard/service/public/detail/pdf_to_markdown

三、关键文档
3.1 项目介绍
在调通的API之后,如果您对我们的工作有兴趣,欢迎阅读文档解析产品介绍,应该能让您对我们的产品更有信心。
3.2 产品文档
| 文档类型 | 链接 | 用途 |
|---|---|---|
| API文档 | textin | 展示api接口的具体用法 |
| 常见问题 | 文档解析 | 一些您可能想要了解的常见问题 |


