400-6666-582
 更多产品






TextIn xParse上架豆包工作:每日 1000 页免费,让办公Agent先“读懂”再执行
豆包工作的用户,现在可以让 Agent 处理那些“最难啃”的文档了。
TextIn xParse 已接入豆包工作插件生态。在「插件 · 技能 · 伙伴」中添加并授权后,百页 PDF 最快 1.5 秒完成结构化解析,每日 1000 页免费额度同步开放。
TextIn xParse 补上的是 Agent 从“拿到文件”到“理解内容”之间最关键的一跳。
01 豆包工作:不只是对话,而是能跨软件干活的办公Agent
豆包工作是字节跳动推出的生产力 Agent 产品。它的特点不是“问一句答一句”,而是围绕一个目标自主拆解任务、调用工具、持续推进。
用户授权后,它可以操作浏览器和电脑,跨软件完成数据整理、网页信息收集、表单填写、资料比对等工作。同时,豆包工作与飞书深度打通。用户用飞书账号登录后,可以调用飞书中沉淀的聊天记录、文档、会议纪要、日程等上下文,让 Agent 基于真实工作信息理解目标、推进任务。
但有一个前提始终存在:Agent 得先准确读到文档里的内容。
02 TextIn xParse:把文档从“能看”变成“Agent稳定理解”
TextIn xParse 是合合信息基于 20 年多模态文本智能技术沉淀推出的通用文档解析服务,专为大模型与企业智能应用打造。
随着 Agent 开始进入真实业务流程,文档处理正在成为一个容易被低估的瓶颈。单份普通 PDF 往往可以直接读取,但一旦遇到长文档、扫描件、复杂表格,或需要一次处理几十上百份材料,Agent 就容易出现漏读、结构丢失、结果难核验等问题。要让 Agent 真正可靠地完成复杂文档任务,需要先把原始文档转化为稳定的机器可理解内容。
TextIn xParse 不是简单的 OCR 工具,而是一套完整的文档智能处理体系——将非结构化文档高效转化为结构化、可追溯、可分析的数据资产。
截至目前,xParse 已服务全球超 1000 家企业,单日处理文档量超 百万页,服务可用性达 99.99%,是国内文档智能领域的代表性产品,也是 OpenClaw、WorkBuddy、Dify 等主流 Agent 生态的常用文档解析工具。
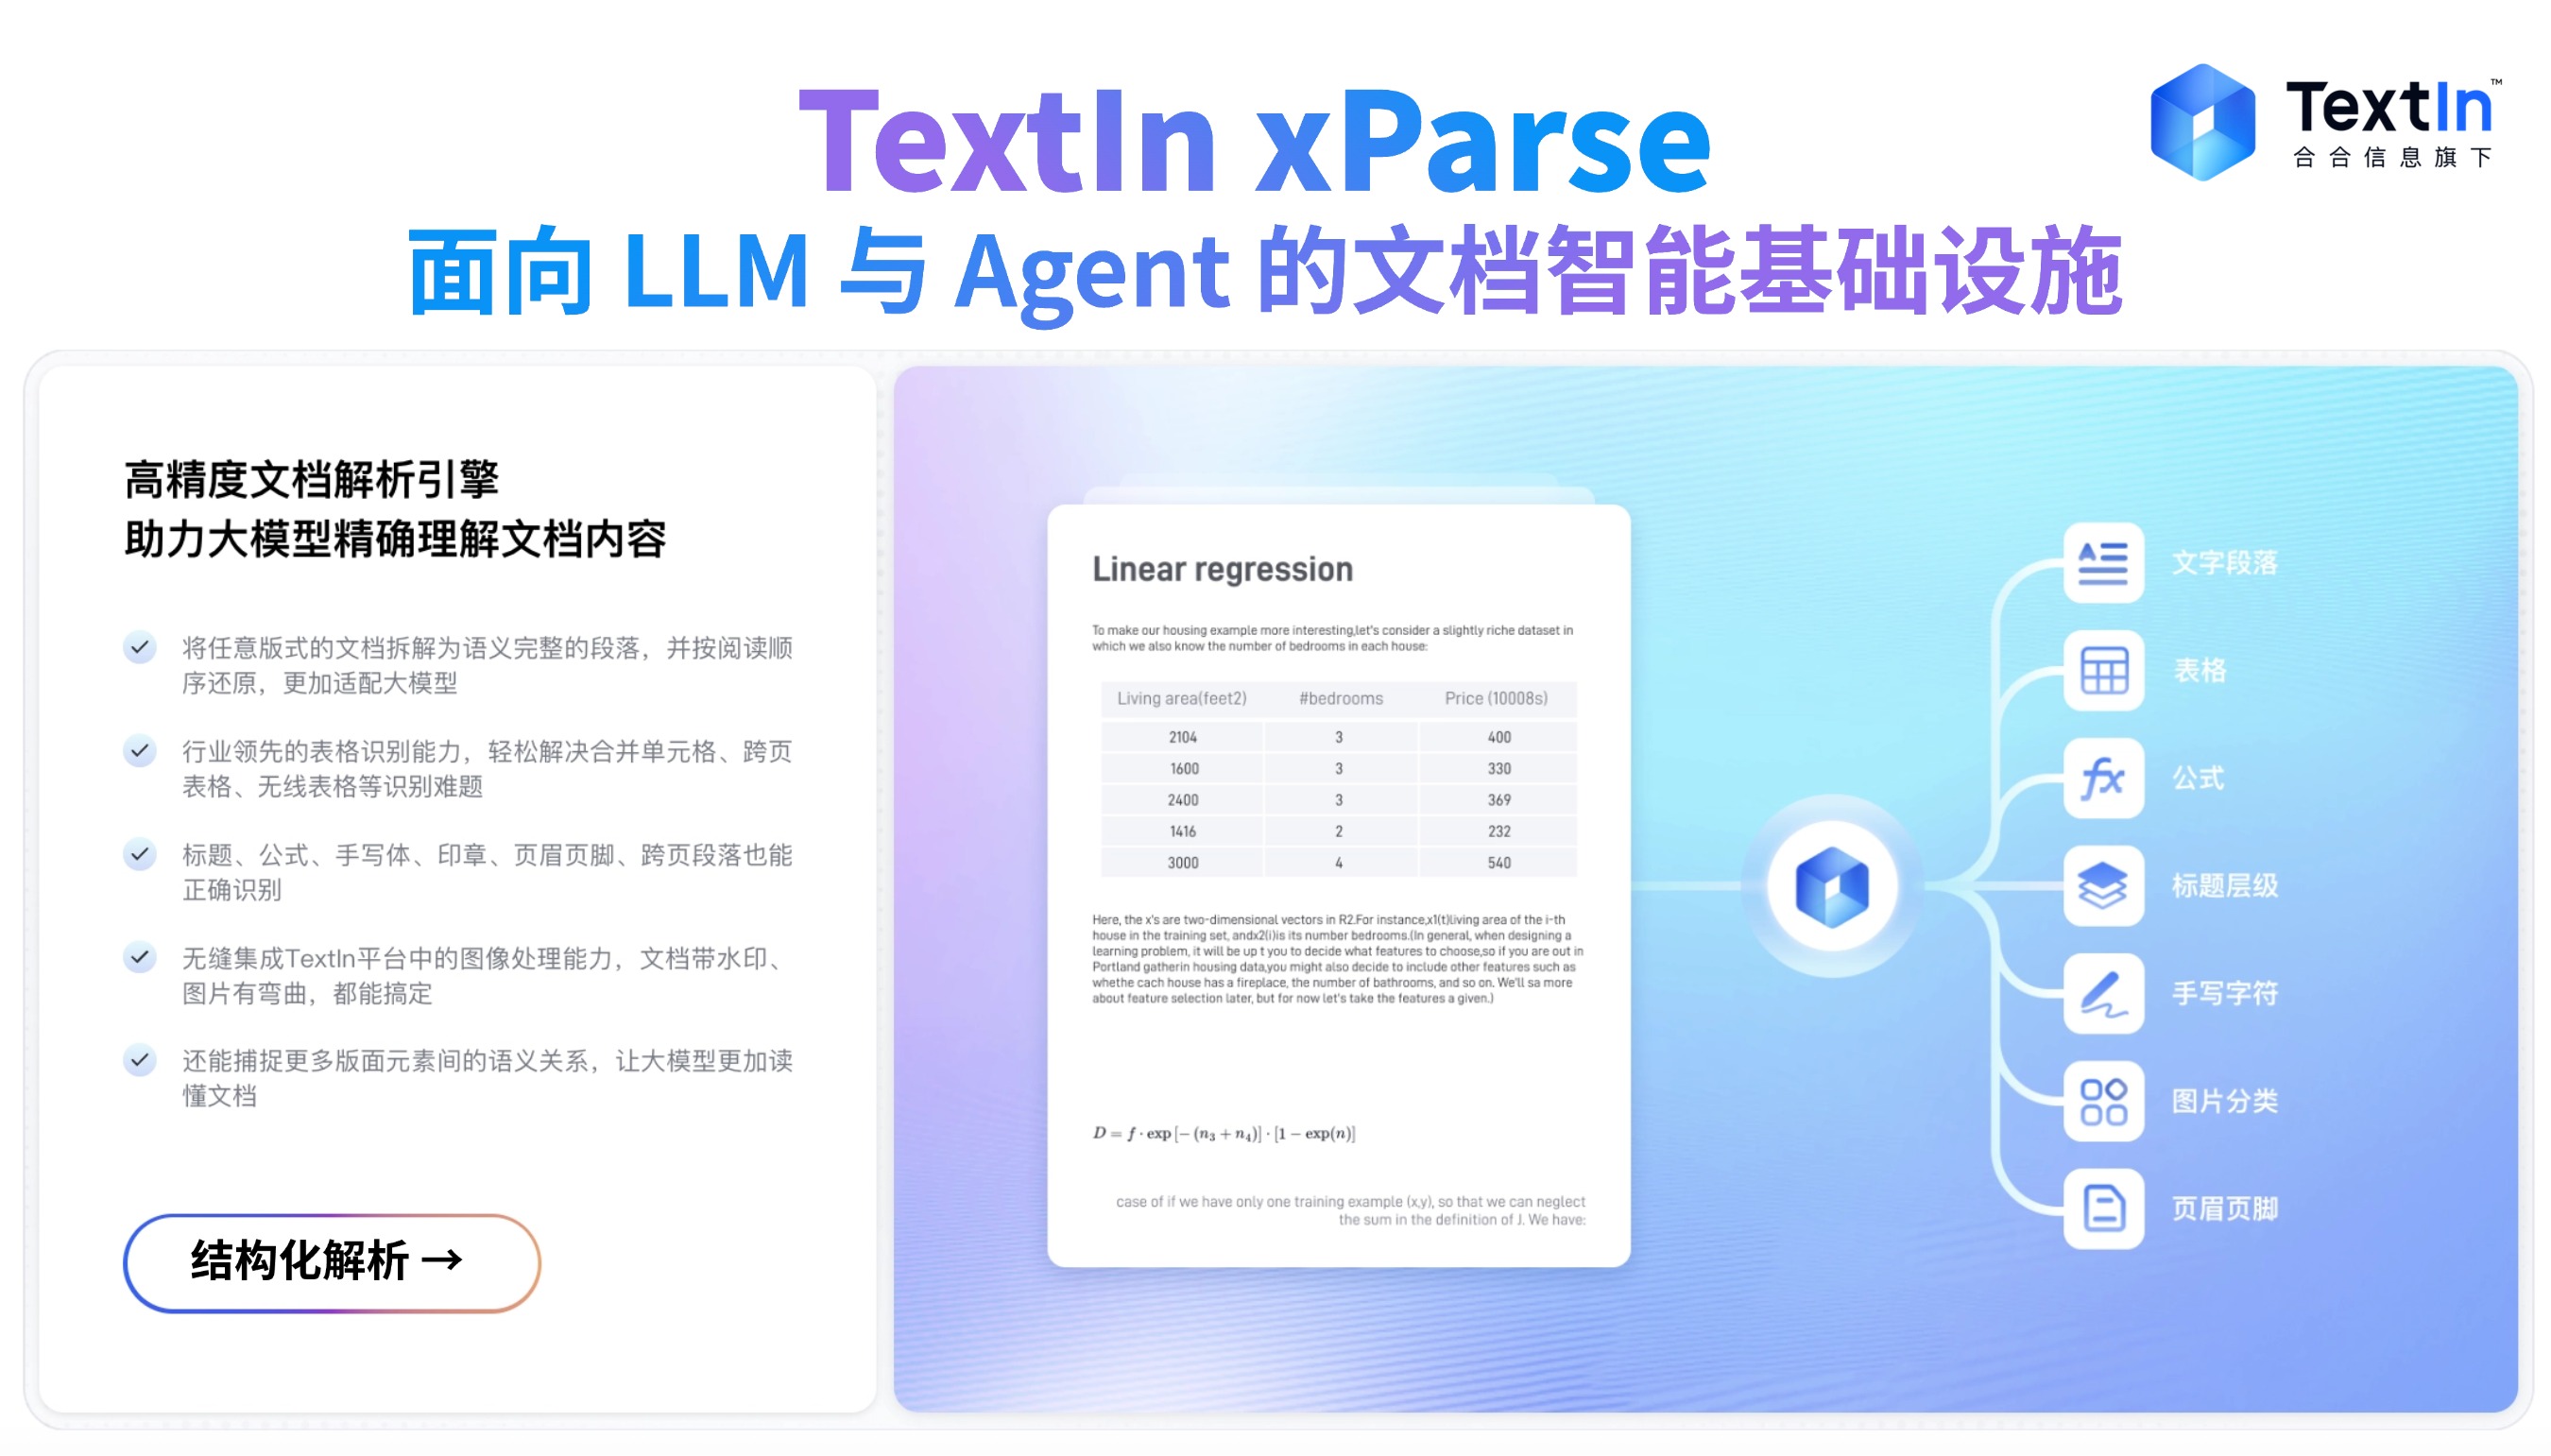
TextIn xParse 核心能力一览
📄 全格式兼容
支持 PDF(含电子档、扫描件) 、Word、Excel、PPT、图片等十余种文件格式。
🧩 深度结构化
精准识别文本、表格、图片、页眉页脚、公式、公章等 16 种内容元素。自动还原标题层级、跨页表格无缝拼接、提取图表坐标轴与数值。
🎯 高精度还原
理解、还原文档结构和元素排列,确保阅读顺序的准确性,针对学术论文、财报、合同标书等多栏排版、图文混排的复杂文档做了专项优化。
🤖 Agent 友好
面向 Agent 的真实文档任务设计,支持长文档、扫描件、复杂表格及多文件批量处理,帮助 Agent 更完整地读取文档、保留原始结构,并为后续信息提取、比对、分析和内容生成提供可靠输入。
⚡ 极速解析
百页级 PDF 文件解析最快 1.5 秒。
📤 标准化输出
解析结果可直接导出为 Markdown、JSON 等格式,方便 LLM、Agent、RAG 及其他下游应用直接消费,无需重复预处理。
🌍 多语言支持
支持简体中文/繁体中文/英文/西欧主流语言/东欧主流语言等 50 余种语言文字识别。
03 个人办公 Agent 的瓶颈,往往不在智商,在“视力”
豆包工作原生具备一定的文档读取能力,但真实办公场景里的文档,很少是干净规整的电子版。
扫描件、拍照件、加密 PDF、跨页表格、多栏研报、带公式的论文、图文混排的标书——这些文档交给原生解析,常见结果是:文字提取出来了,但结构丢了;表格读出来了,但行列对不上;长文档读到一半,速度下降甚至截断。
更麻烦的是,当任务从一份文档变成几十份材料、从简单阅读变成全量核对时,Agent 还需要知道哪些文件已经处理、同一信息在不同材料里是否一致、差异出现在哪里,以及最终结论来自哪一页原文。
用户在真实场景中经常遇到的,并不是 Agent “不会分析”,而是一份文件能读,很多份容易漏;内容能总结,但不知道是不是全部看完;结果能给出来,却很难快速回到原文核验。
Agent 会规划、会推理、也能调用工具,但如果输入本身不完整,多份材料之间又没有被可靠地对齐和追溯,后面的分析再聪明,也可能建立在错误的基础上。
xParse 接入后,豆包工作的文档处理链路变成:用户下达自然语言指令 → 豆包工作调用 xParse 完成高精度解析 → Agent 基于结构化数据执行分析、总结、比对、生成报告等任务。全程不离开工作台。
结合豆包工作已有的飞书上下文、浏览器操作、云电脑和多 Agents 并行能力,Agent 能直接实现:
场景一:会前资料包快速消化
飞书会议邀请里附了多份 PDF、PPT 和扫描件?让豆包工作先调用 xParse 解析,再基于飞书日程、聊天记录和文档上下文,自动生成议题摘要、参会人背景、待确认问题清单。会前十分钟,也能把材料吃透。
场景二:多家供应商资料并行比对
从浏览器下载或飞书收到的多家供应商 PDF 报价、资质文件,交给 xParse 结构化后,豆包工作可以分派多个子 Agent 并行抽取报价、交付周期、资质信息,最后汇总成一张对比表。人不用来回切换文件,也不用手动复制粘贴。
场景三:发票、报销单据批量整理
手机拍照或扫描生成的发票 PDF,经 xParse 识别发票号、金额、抬头、开票日期和明细后,豆包工作可以按项目、部门或时间自动归类,生成报销汇总表。个人办公里最琐碎的一类文档任务,可以交给 Agent 跑。
场景四:长研报、行业资料速读
几十上百页的研报、白皮书、招股书,xParse 先还原标题层级、图表和表格结构,豆包工作再生成摘要、提取关键数据、整理成可问答的知识库。需要长期跟踪的行业资料,也可以持续沉淀下来。
04 怎么开启?一次连接,然后直接派活
上手不需要代码,也不需要额外配置解析工具:
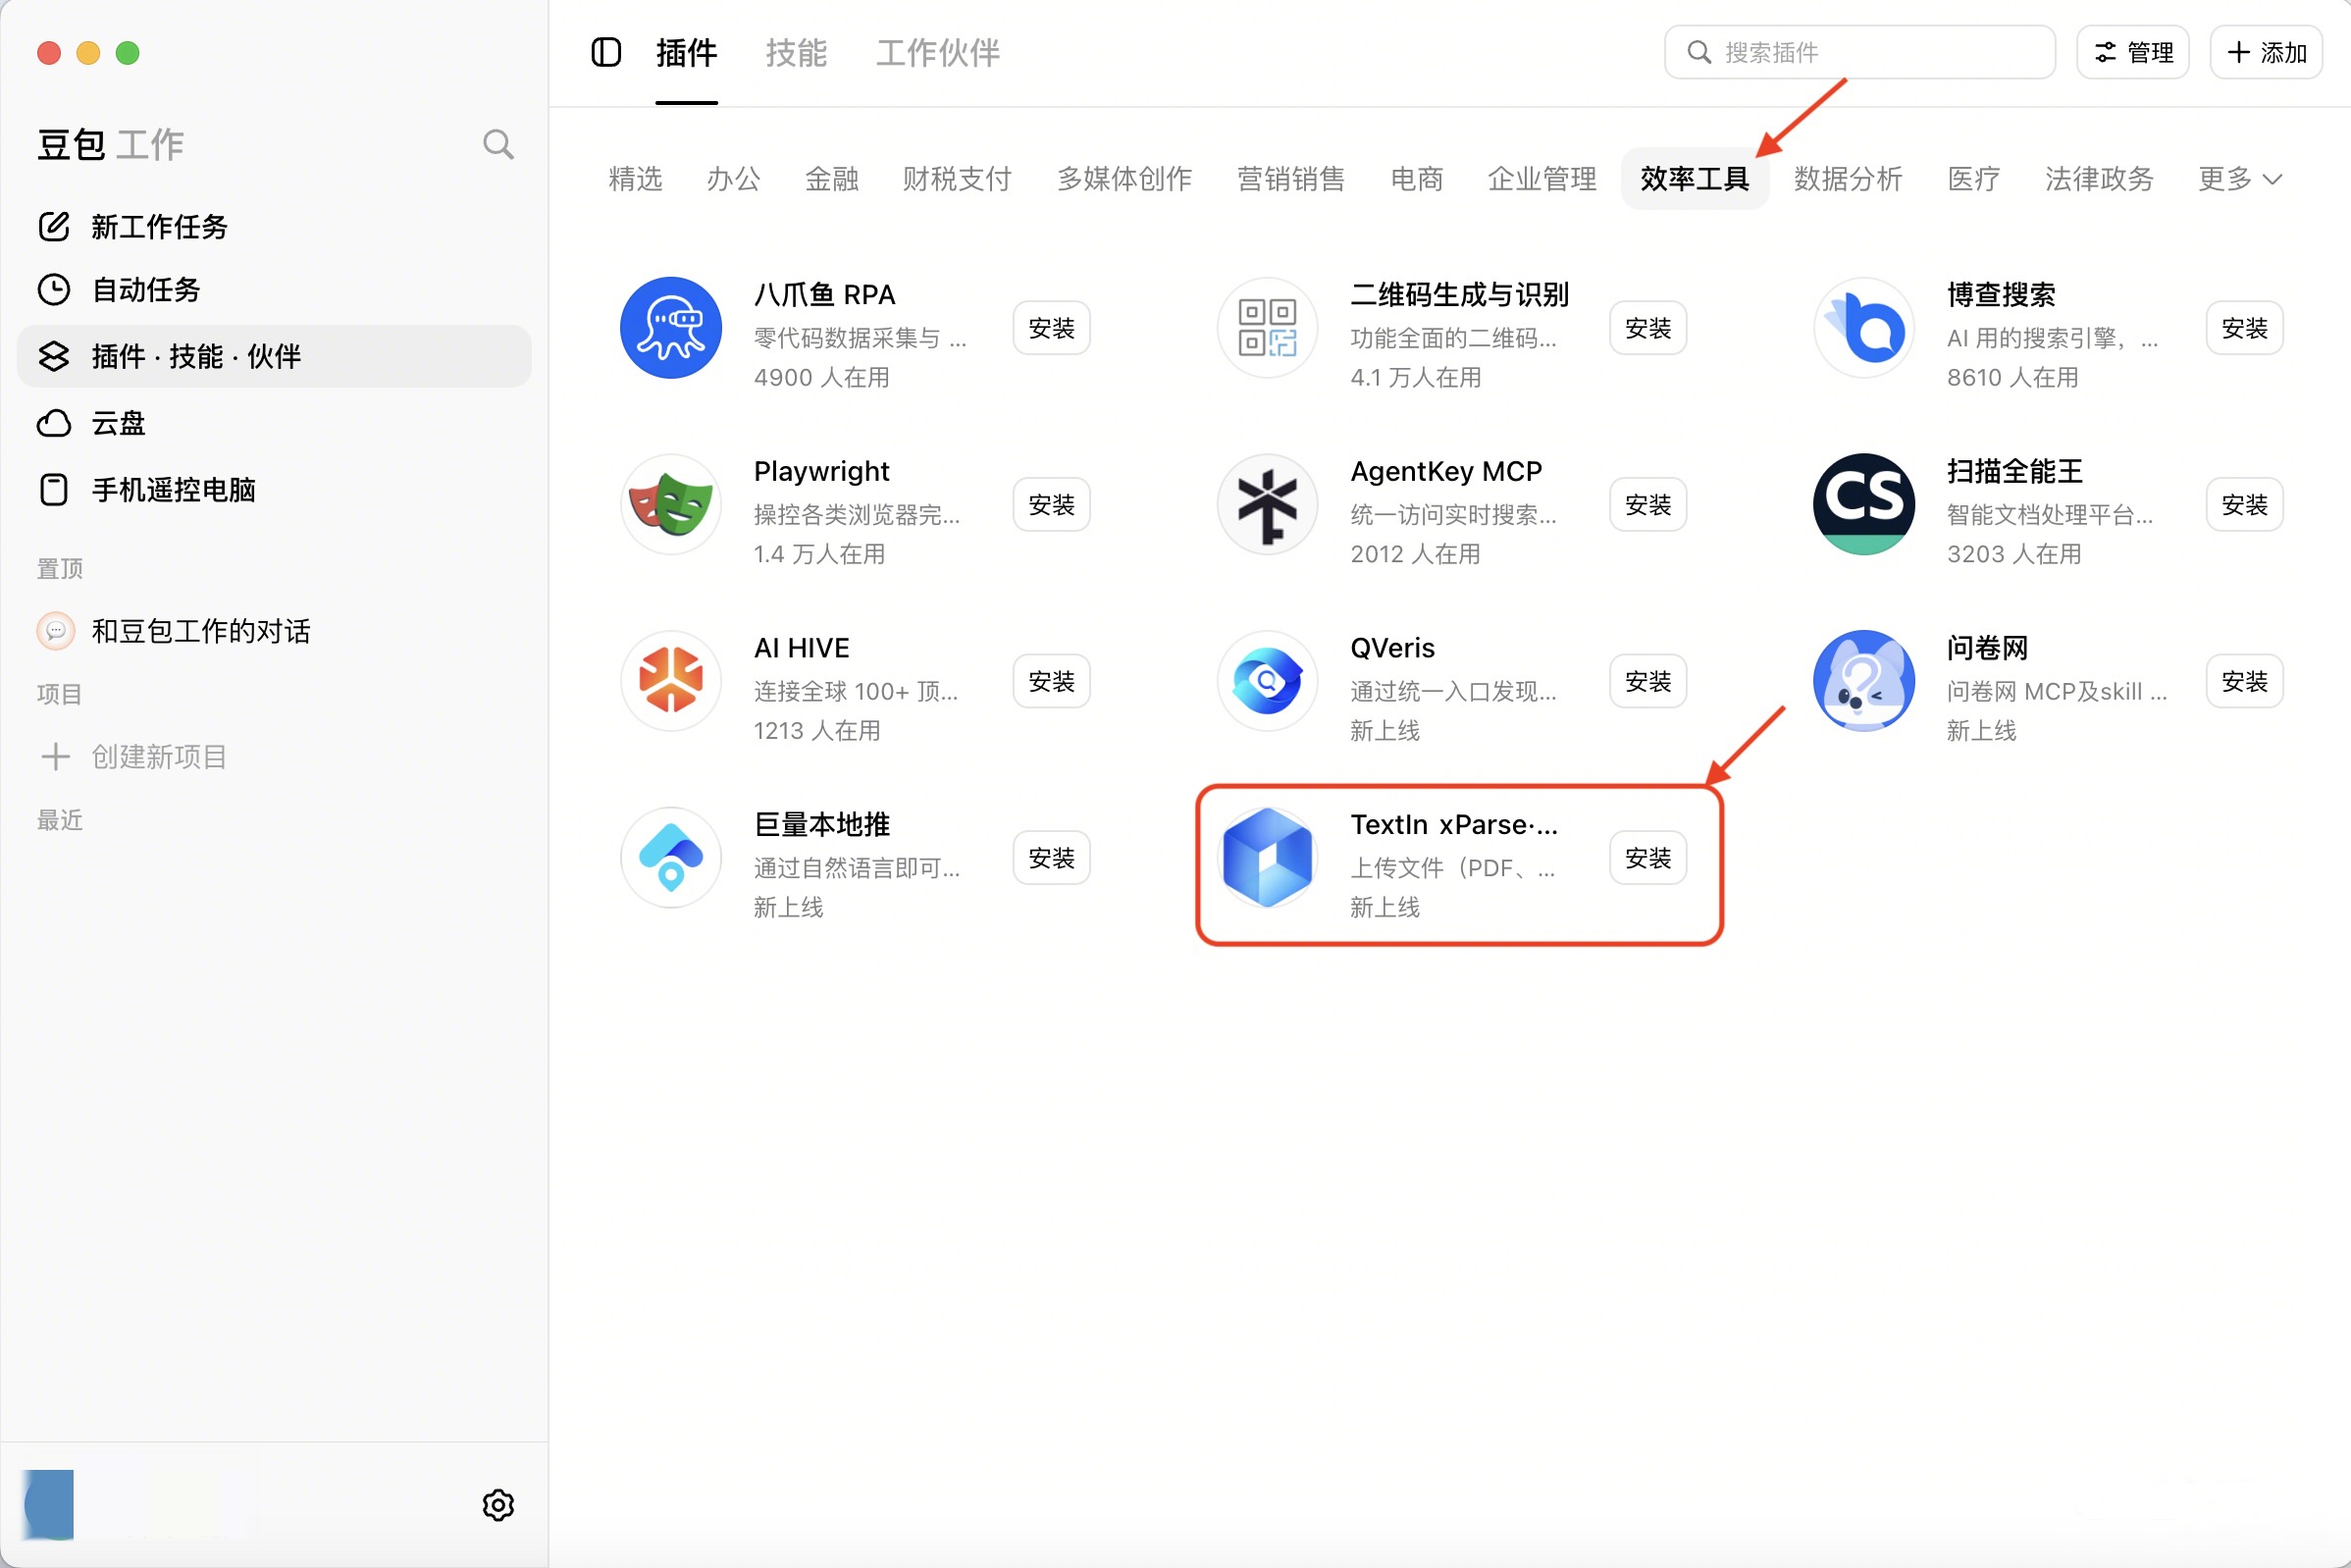
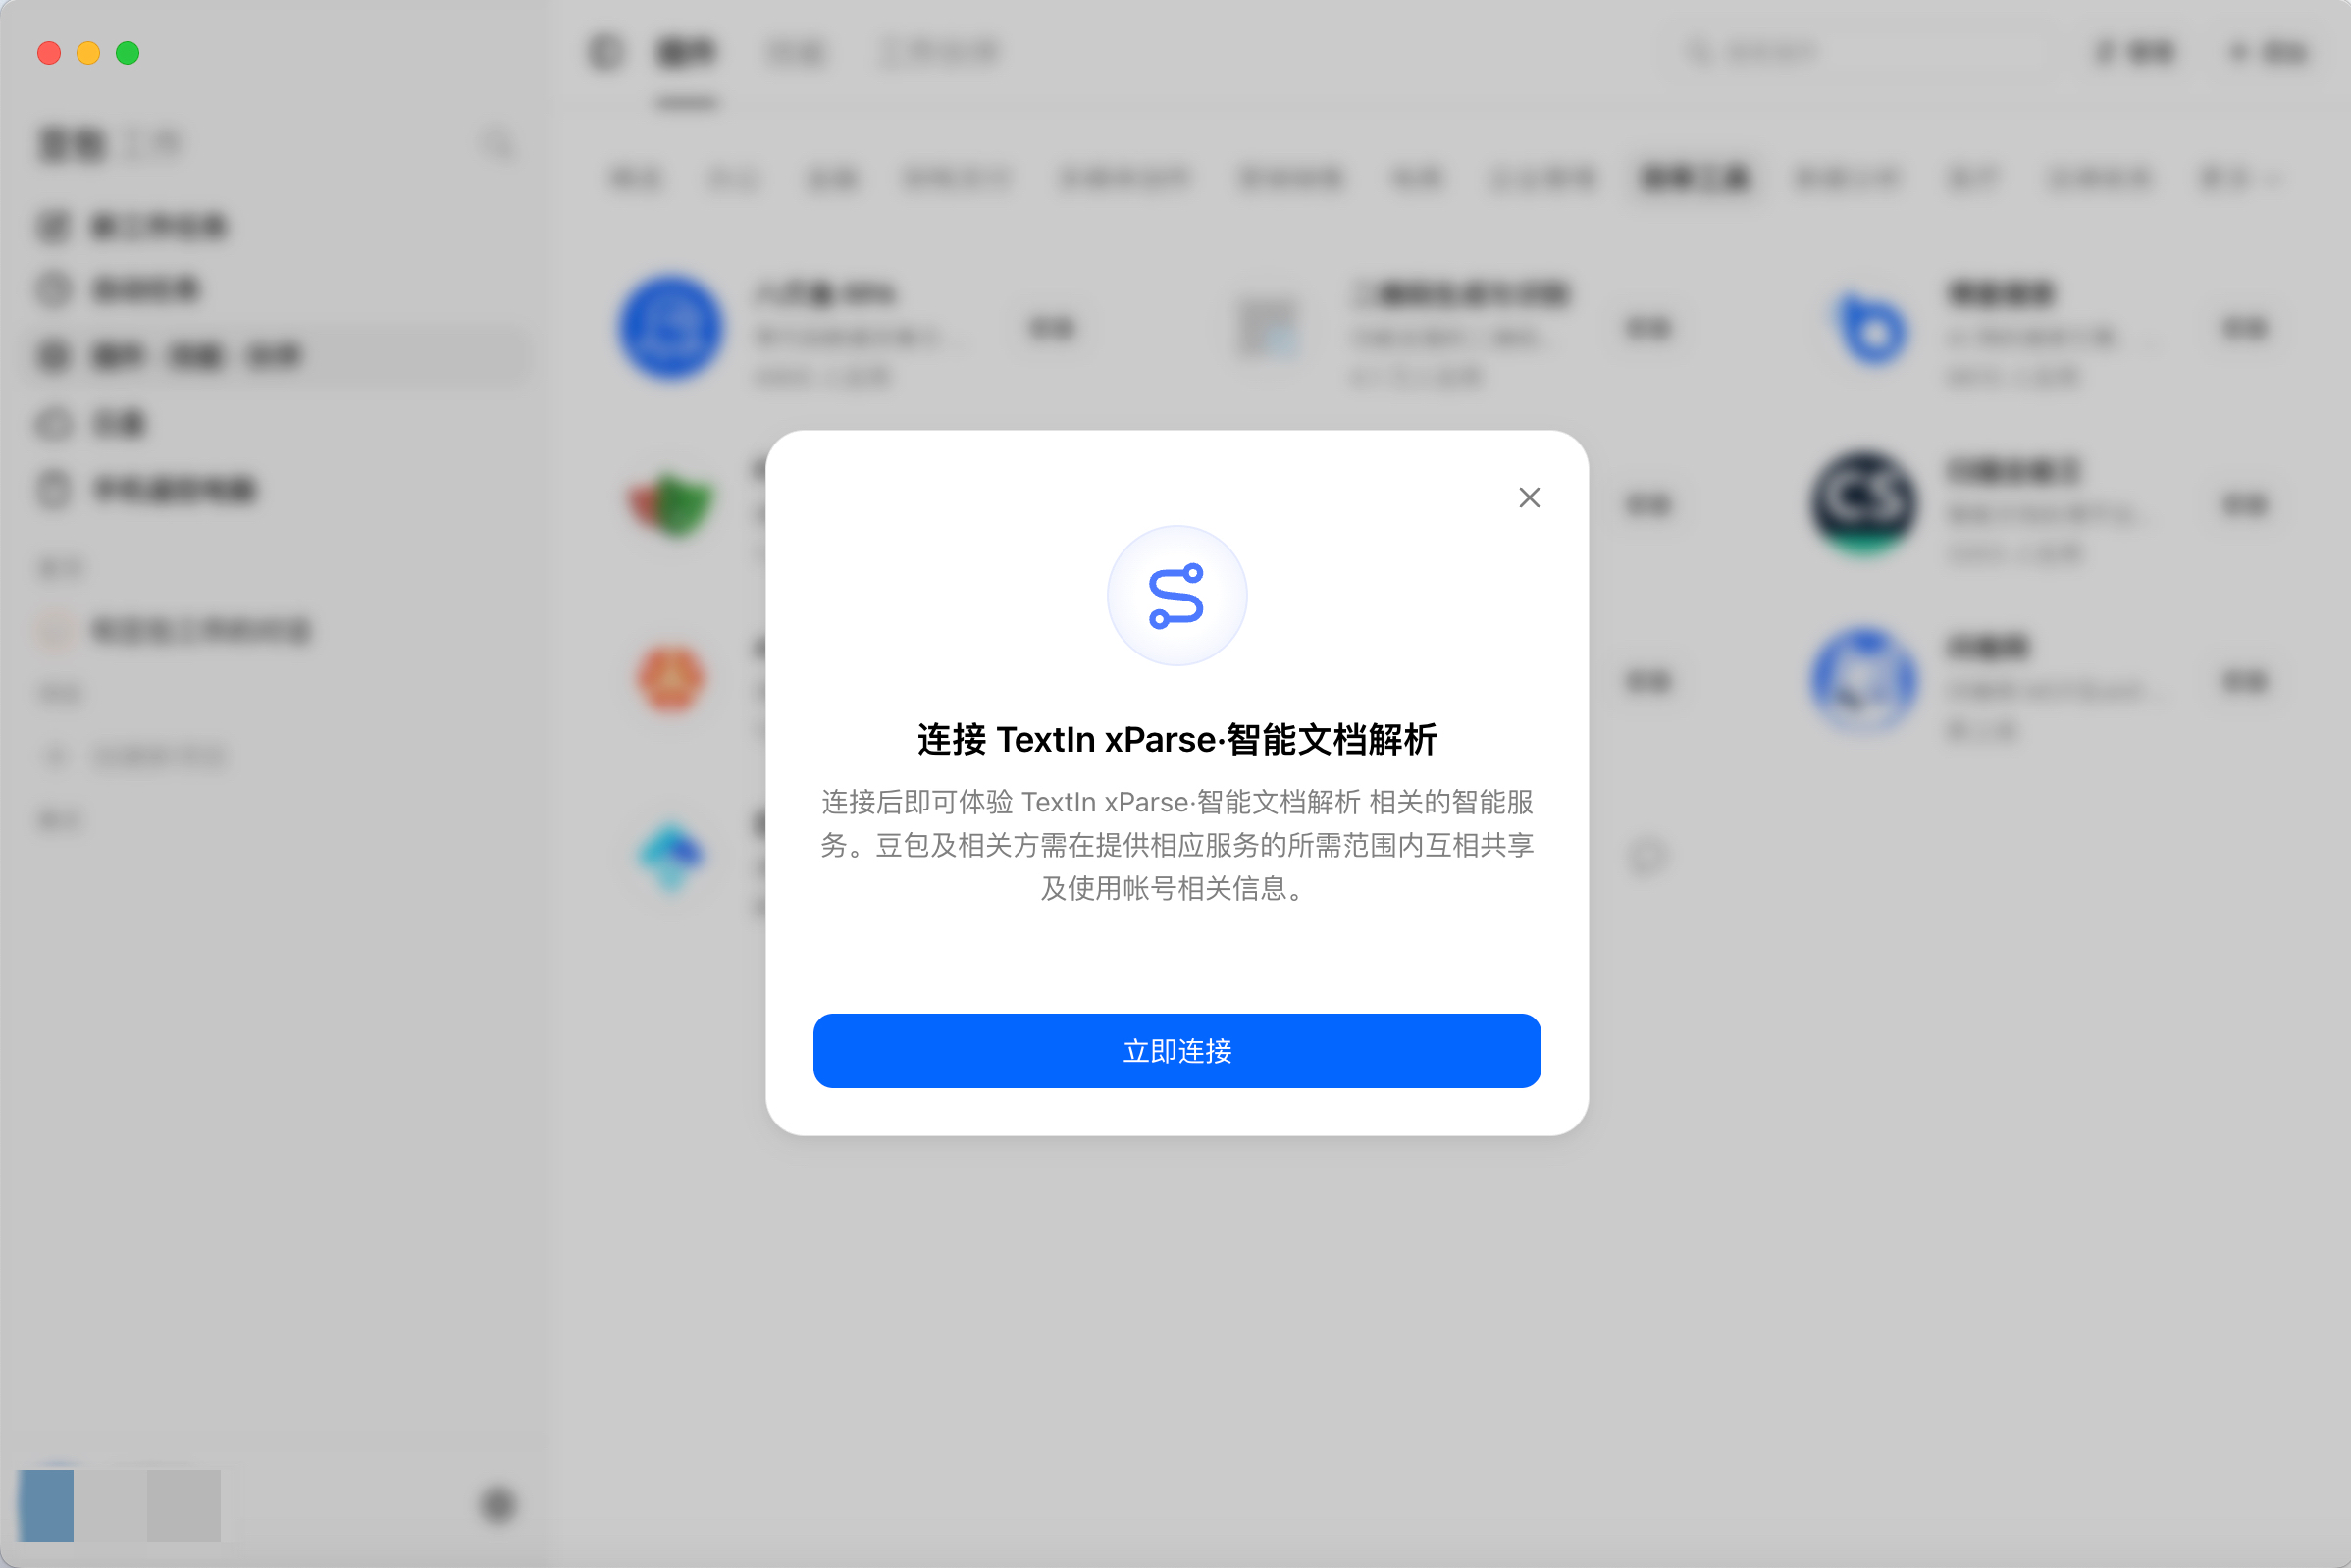
打开豆包工作,进入「插件 · 技能 · 伙伴」。
在「效率工具」找到 TextIn xParse 或直接搜索,点击安装并完成连接。
在对话或任务中上传文档,直接用自然语言描述目标。
可以直接复制这些指令试试:
“使用 TextIn xParse 解析这份扫描版招股书,把前五大客户表格整理成 Markdown。”
“把这份会议材料包里的 PDF 通过 xParse 全部解析,按议题生成会前摘要。”
“用 xParse 读取这些发票 PDF,提取金额、抬头、开票日期,汇总成表格。”
“用 xParse 解析这份研报,提取核心财务数据和风险提示,生成一页摘要。”
TextIn xParse 为豆包工作用户提供 每日 1000 页解析额度,不需要额外申请,商业级能力零门槛接入。
了解更多:访问 TextIn 官网 或豆包工作官方文档。
文档解析不该是 Agent 任务里的暗礁,TextIn xParse 在豆包工作里待命,免费额度已经预留。下一次遇到 Agent 读不懂的 PDF,先让豆包工作用 xParse 试试。