400-6666-582
 更多产品






公式不乱、手写不混:TextIn xParse让试卷变成结构化数据,赋能AI批改、错题整理与学情分析
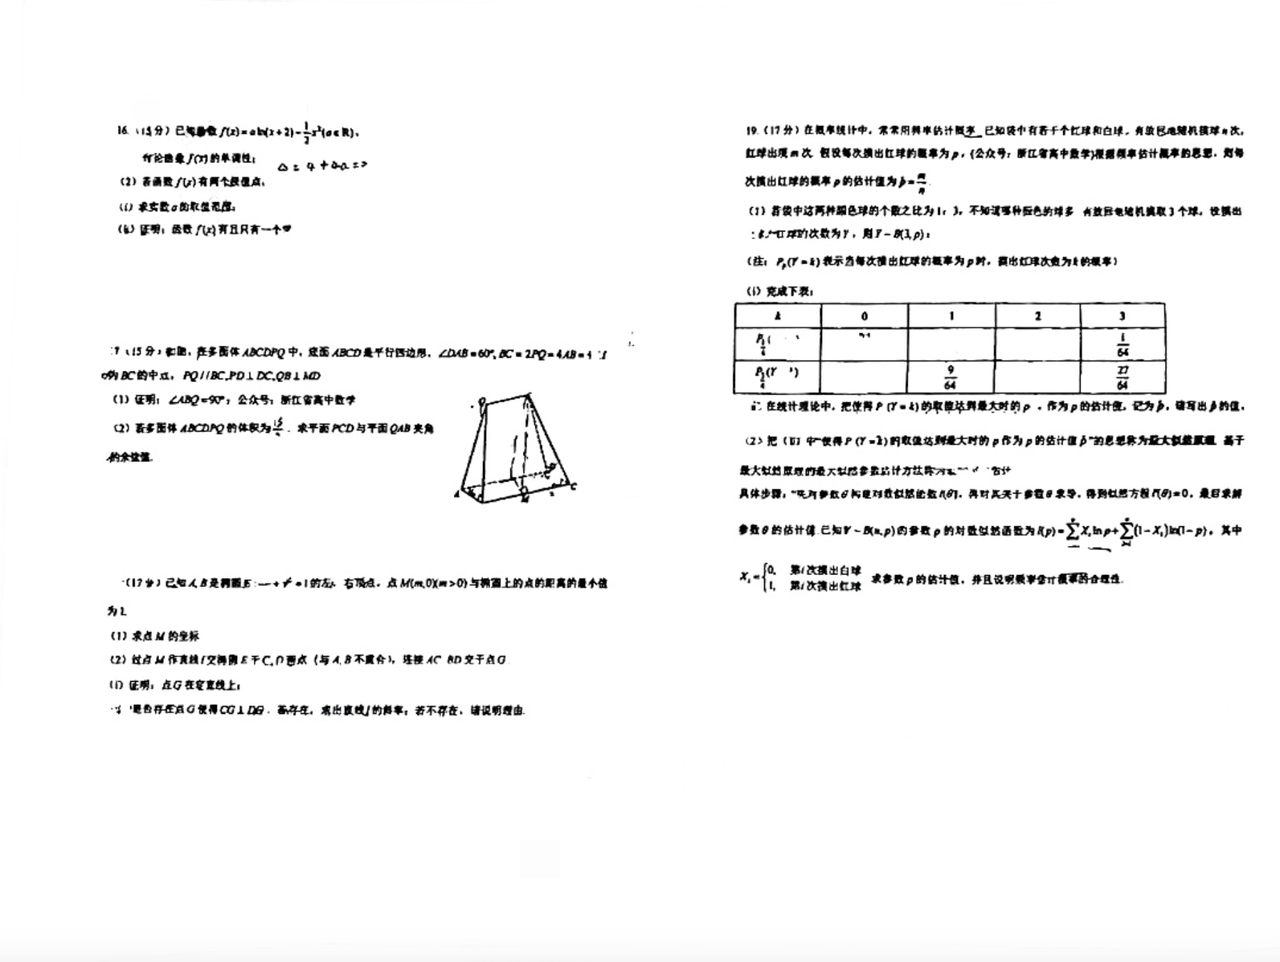
每年考试季前后,学生、家长、老师和教学机构都要和试卷打一场“持久战”:卷子要批改,错题要整理,题目要录入题库。
随着智能批改、错题整理类产品逐渐普及,越来越多团队想用 AI 把这条链路自动化,但接入后往往发现,最难的不是上层算法,而是第一步:把试卷“看清楚”。
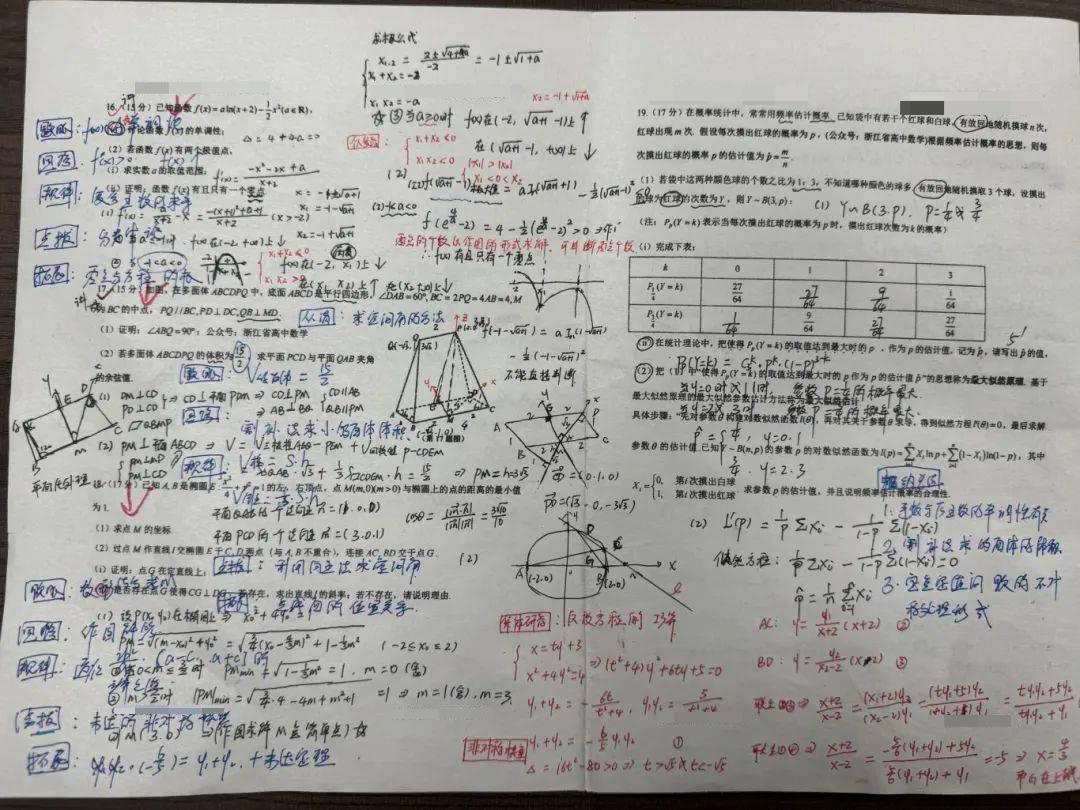
初高中试卷,尤其是数学物理等理科卷子,是文档里很难处理的类型:印刷体公式、手写解题步骤、红笔批改、复杂版面交织在同一页;手机拍摄又带来透视畸变、阴影和折痕。普通 OCR 在这样的输入上错误率直线上升,公式变形、手写漏识、版面错乱。底层文本错了,上层再聪明的模型,也无法给出正确的批改和整理结果。
一张卷子从纸面到屏幕,中间隔着一层“看得清”的解析。
一、试卷解析,具体难在哪?
版面结构复杂
初高中数理试卷常见双栏排版、图文环绕、答题区留白、题号跨栏。一道物理大题可能左边是题干,右边是受力分析图,下面还有三个小问。
传统OCR按页面从上到下逐行输出,题干、选项、图形说明很容易被拆散。阅读顺序一乱,题目结构就没有了。
公式还原要求极高
数学里的分式、根号、上下标、积分号,物理里的矢量符号、单位、希腊字母,都是高频内容。
普通文本提取工具遇到这些内容,要么跳过,要么输出乱码。公式不是普通文字,它必须被还原成可编辑、可渲染的LaTeX结构。
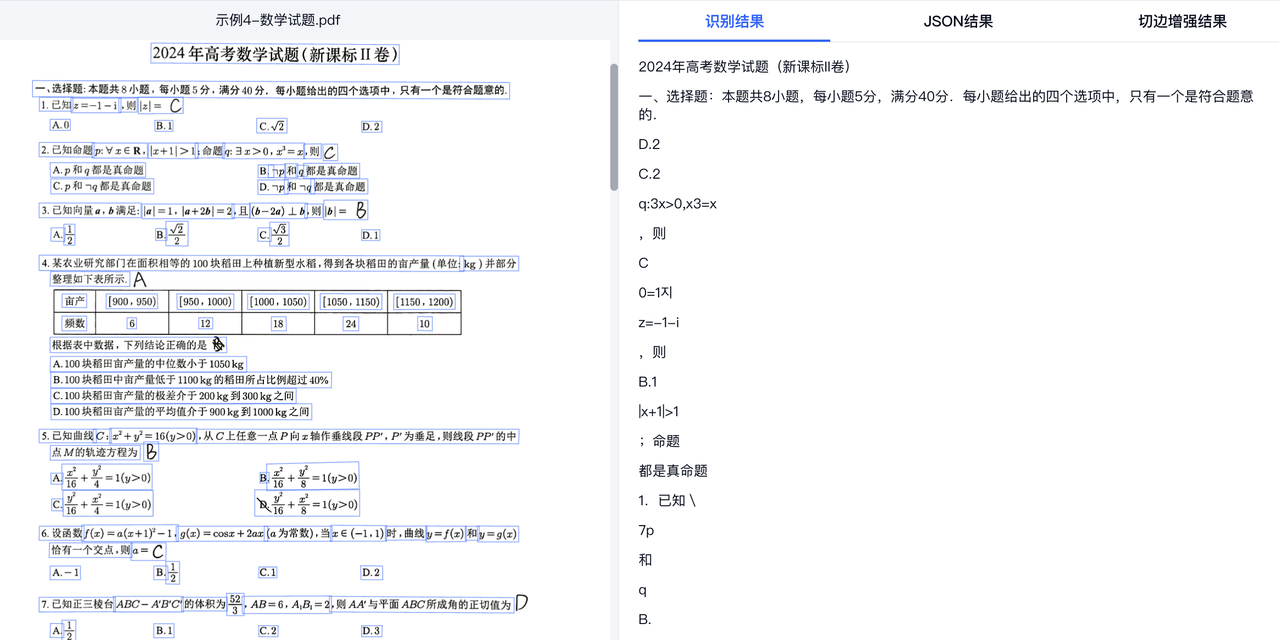
传统OCR识别结果
手写与印刷体混排
一张试卷通常同时包含印刷题干和手写内容,部分试卷还带有批改符号与文字批注。不同内容相互交叠,容易导致题干、答案与批改痕迹混在一起,影响题目切分和文本提取。
解析系统需要准确区分印刷体与手写体,并尽可能保留各部分的位置关系,为后续的智能批改、错题整理与题库建设提供可靠数据。
拍照质量不可控
老师和学生用手机拍卷,常常有倾斜、阴影、折痕、光照不均。试卷本身还可能卷曲、重叠。解析引擎必须先做切边矫正,再谈识别。
二、TextIn xParse:试卷处理的智能解析底座
TextIn xParse 是面向复杂文档的解析工具,支持 PDF、扫描件、Word、图片等多种输入,把非结构化文档转化为稳定、可追溯的结构化数据。
公式解析直接输出LaTeX
xParse能够识别行内公式和独立公式,输出可编辑的LaTeX代码。分式、根号、上下标、积分、化学方程式、物理单位,都能结构化返回。下游批改模型拿到的不是“v=根号2gh”这样的文本碎片,而是 v=\sqrt{2gh} 这样的标准表达式,可以直接参与比对和计算。
版面分析做到元素级切分
引擎先理解页面,把内容拆成文本块、公式、表格、图片、手写区域等元素类型,再按原始阅读顺序重新组装。双栏试卷会识别栏位边界,跨栏题目会正确关联。图形和表格也能保留位置关系,不会在文本流中丢失。
手写识别与分层
xParse 内置手写识别模型,能够识别试卷中混排的印刷体与手写体,并结合版面位置,提取题干、公式和手写内容等信息。在手写识别的基础上进行擦除,即可保留印刷体题干和图形,清除手写作答和批改痕迹,输出干净的空白试卷图像。这个能力对错题重练和组卷复用非常关键。
使用便捷,接入灵活
xParse 支持 API 直接调用,也可以接入 Agent 工作流。用户不需要自己训练解析模型,一次请求返回文字、表格、标题层级、公式、手写字符和图片的结构化信息,输出Markdown或JSON。百页文档在线解析最快1.5秒,支持高并发调用。教育机构把它作为数据预处理层,解析结果直接送入现有的批改引擎或题库系统。
三、xParse 落地试卷场景:批改、错题本、题库与学情分析
xParse 将试卷中的题干、公式、手写内容和版面关系转化为结构化数据,为批改系统、题库系统和教学 Agent 提供统一、可复用的数据输入,让试卷内容成为 AI 能稳定理解的数据资产。
智能批改:从试卷识别到自动评阅
试卷解析完成后,智能批改是最常用的场景之一。不同题型的判题逻辑各有侧重:客观题在提取学生答案后与标准答案匹配,主观题和计算题则需要结合解题步骤、公式与最终答案进行评分。但无论哪种题型,判题都有一个共同前提:题干和学生作答必须先被准确提取,其中的公式还要转换为规范、可计算的 LaTeX。
比如一道自由落体物理题,标准答案是 :xParse 把学生手写的准确识别为 LaTeX,大模型才能判断公式正确、代入正确,给出满分;如果学生手写的是v=2gh,xParse 如实输出,系统便能定位到根号缺失,判为错误并给出扣分点。同一份潦草手写,如果解析环节错一个字符,满分就变成误判。
这里大模型只负责判题,不负责“看卷”——“看卷”已经由 xParse 完成。公式不乱、手写不混,批改模型拿到的输入就是干净的,判分才有依据。
错题整理:自动归档并生成个性化错题集
批改完成后,系统根据判题结果定位错题,并利用 xParse 对试卷中的印刷体、手写体、公式及版面结构进行识别。在此基础上,下游应用可进一步提取题干、公式和配图,重新生成不含手写内容的干净题目,再按学科和知识点归档到学生的错题本中,生成个性化错题集 PDF,供学生打印重练。错题按知识点分类后,学生也能更快定位薄弱环节,进行针对性复习。
题库建设:试题结构化沉淀与灵活组卷
解析后的题目可以直接入库,题干、选项、公式、图形、答案各自独立存储。公式以LaTeX形式保存,可检索、可渲染;图形保留原始坐标和裁剪区域,可复用。
老师想组一份新卷子时,按知识点、难度、题型筛选,系统自动从题库中抽取题目拼卷,不需要重新录入。一道题解析一次,可以在不同班级、不同学期的组卷中反复使用。对于机构来说,题库积累得越多,组卷效率越高,边际成本越低。
学情分析:从作答结果定位知识薄弱点
每道题被正确切分后,才能准确映射到教材章节和知识点。一个学生反复在“牛顿第二定律”相关题目上出错,系统才能给出针对性的学习建议。如果题干识别错一个条件,知识点映射就可能从“牛顿第二定律”跑到“机械能守恒”,后续推荐和统计全部失真。班级层面也一样:哪道题错误率最高、哪个知识点全班掌握最差,这些统计都依赖题目结构的准确解析。解析质量决定了学情分析的上限。
四、一个完整链路示例:从拍卷到批改和错题本整理
以一道初中数学题为例,展示“批改 + 错题本整理”的完整链路。
原卷是一道印刷题干加手写作答的解答题:已知关于 x 的一元二次方程 x²-4x+m=0 有两个相等的实数根,求 m 的值。学生手写作答:“有两个相等的实数根,所以 Δ=b²-4ac=16-4m=0,解得 m=−4。”
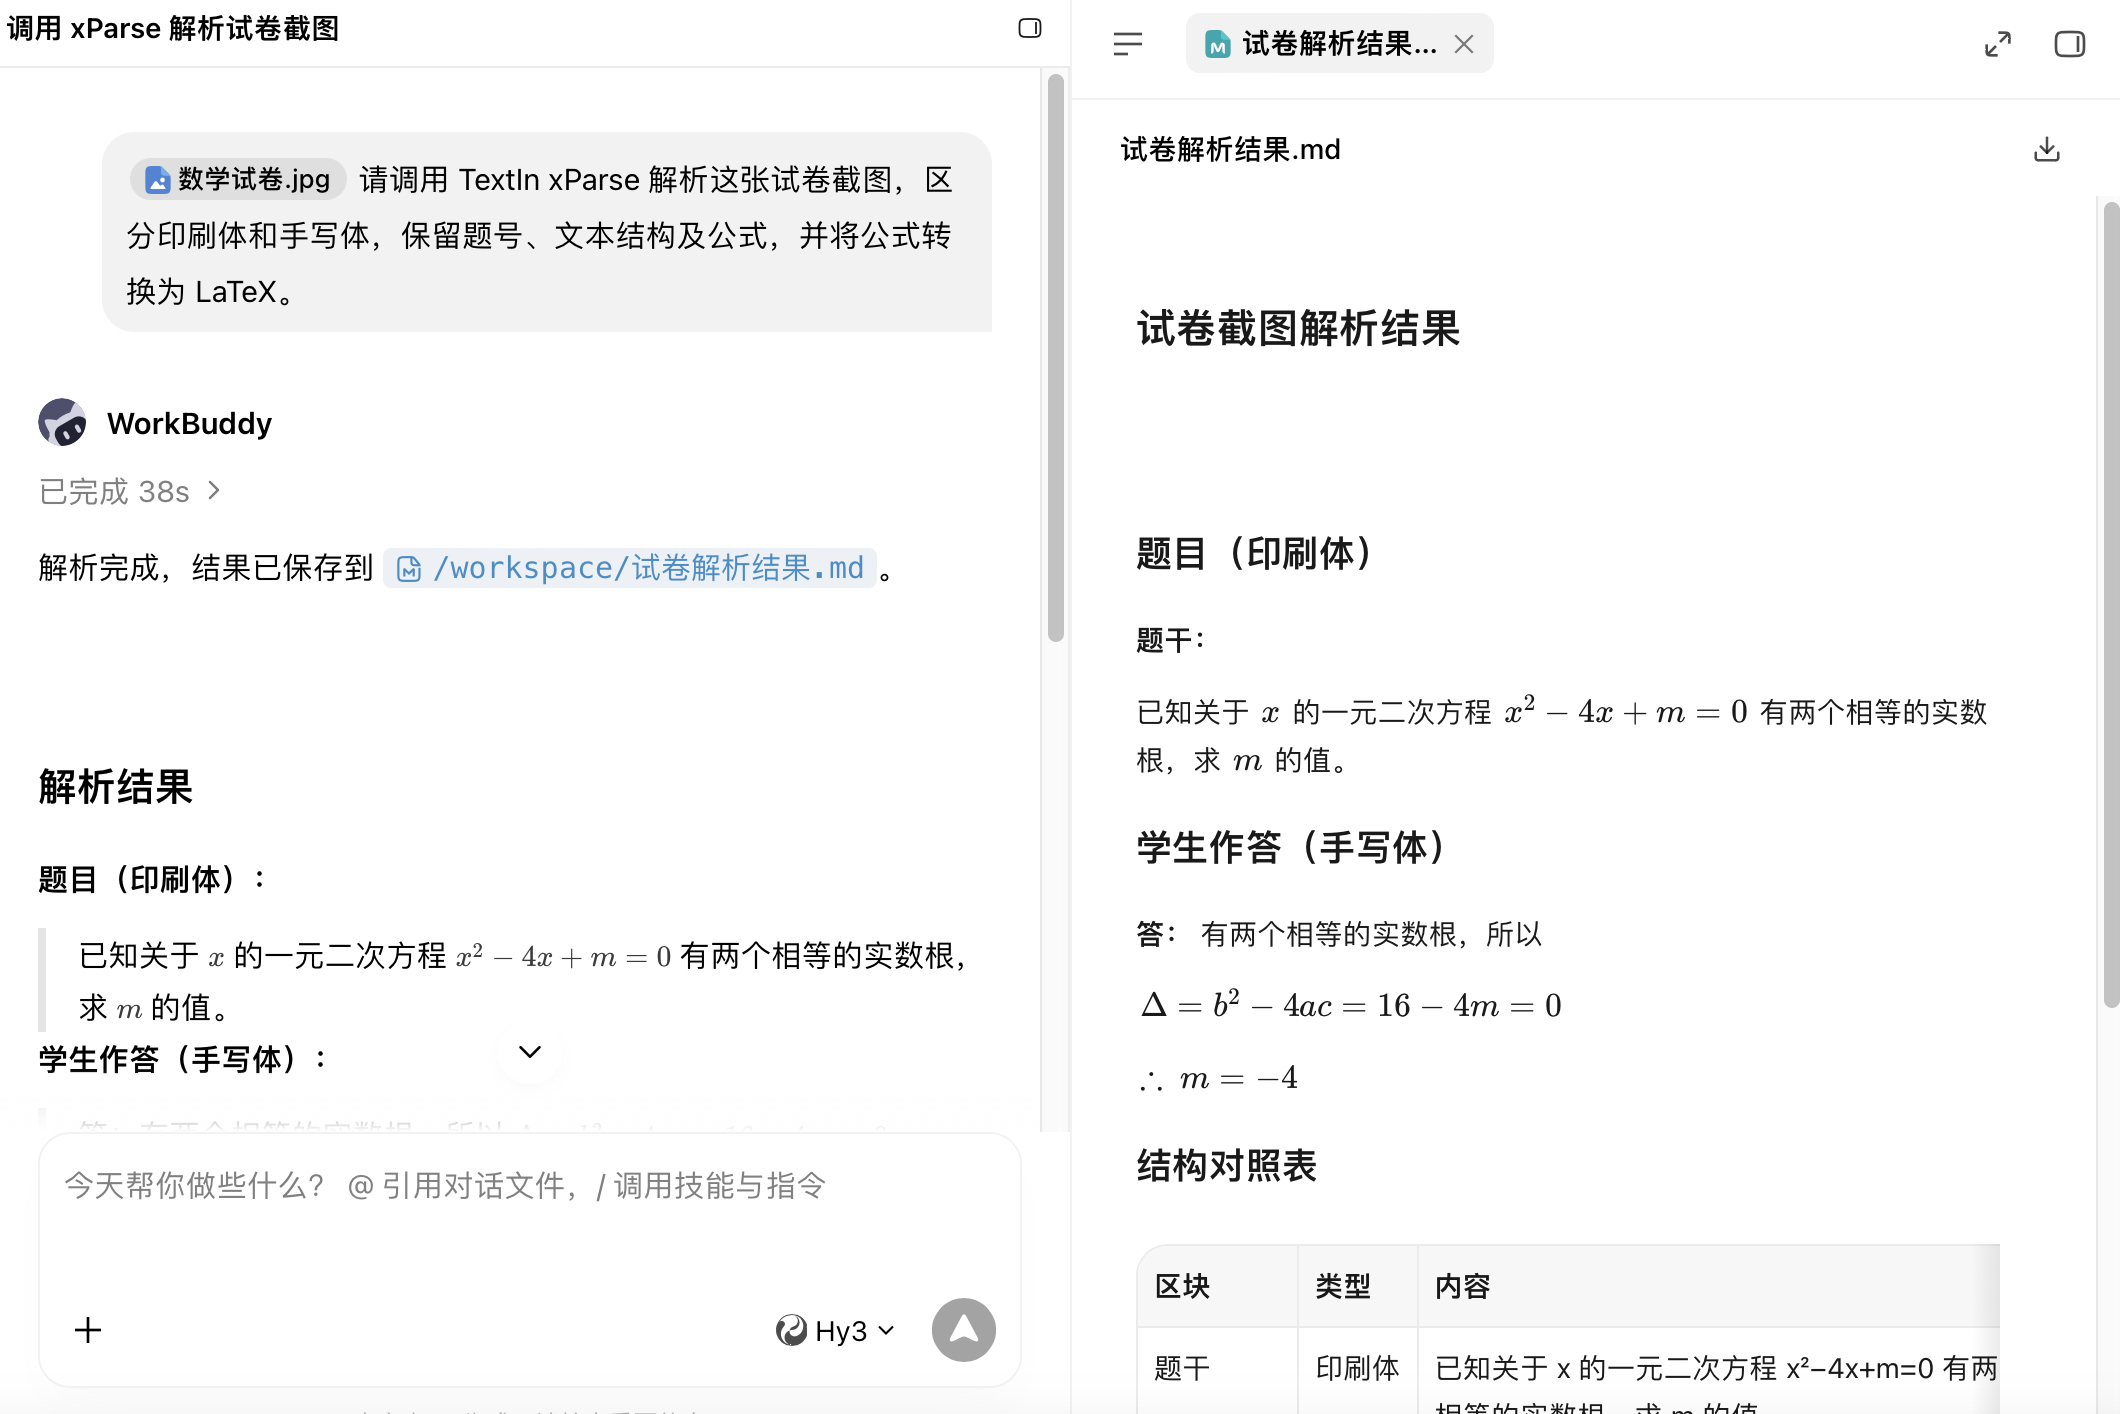
经 xParse 解析,得到结构化文本:
题目(印刷体):已知关于 $x$ 的一元二次方程 $x^2 - 4x + m = 0$ 有两个相等的实数根,求 $m$ 的值。

学生作答(手写体):答:有两个相等的实数根,所以 $\Delta = b^2 - 4ac = 16 - 4m = 0$,$\therefore m = -4$。
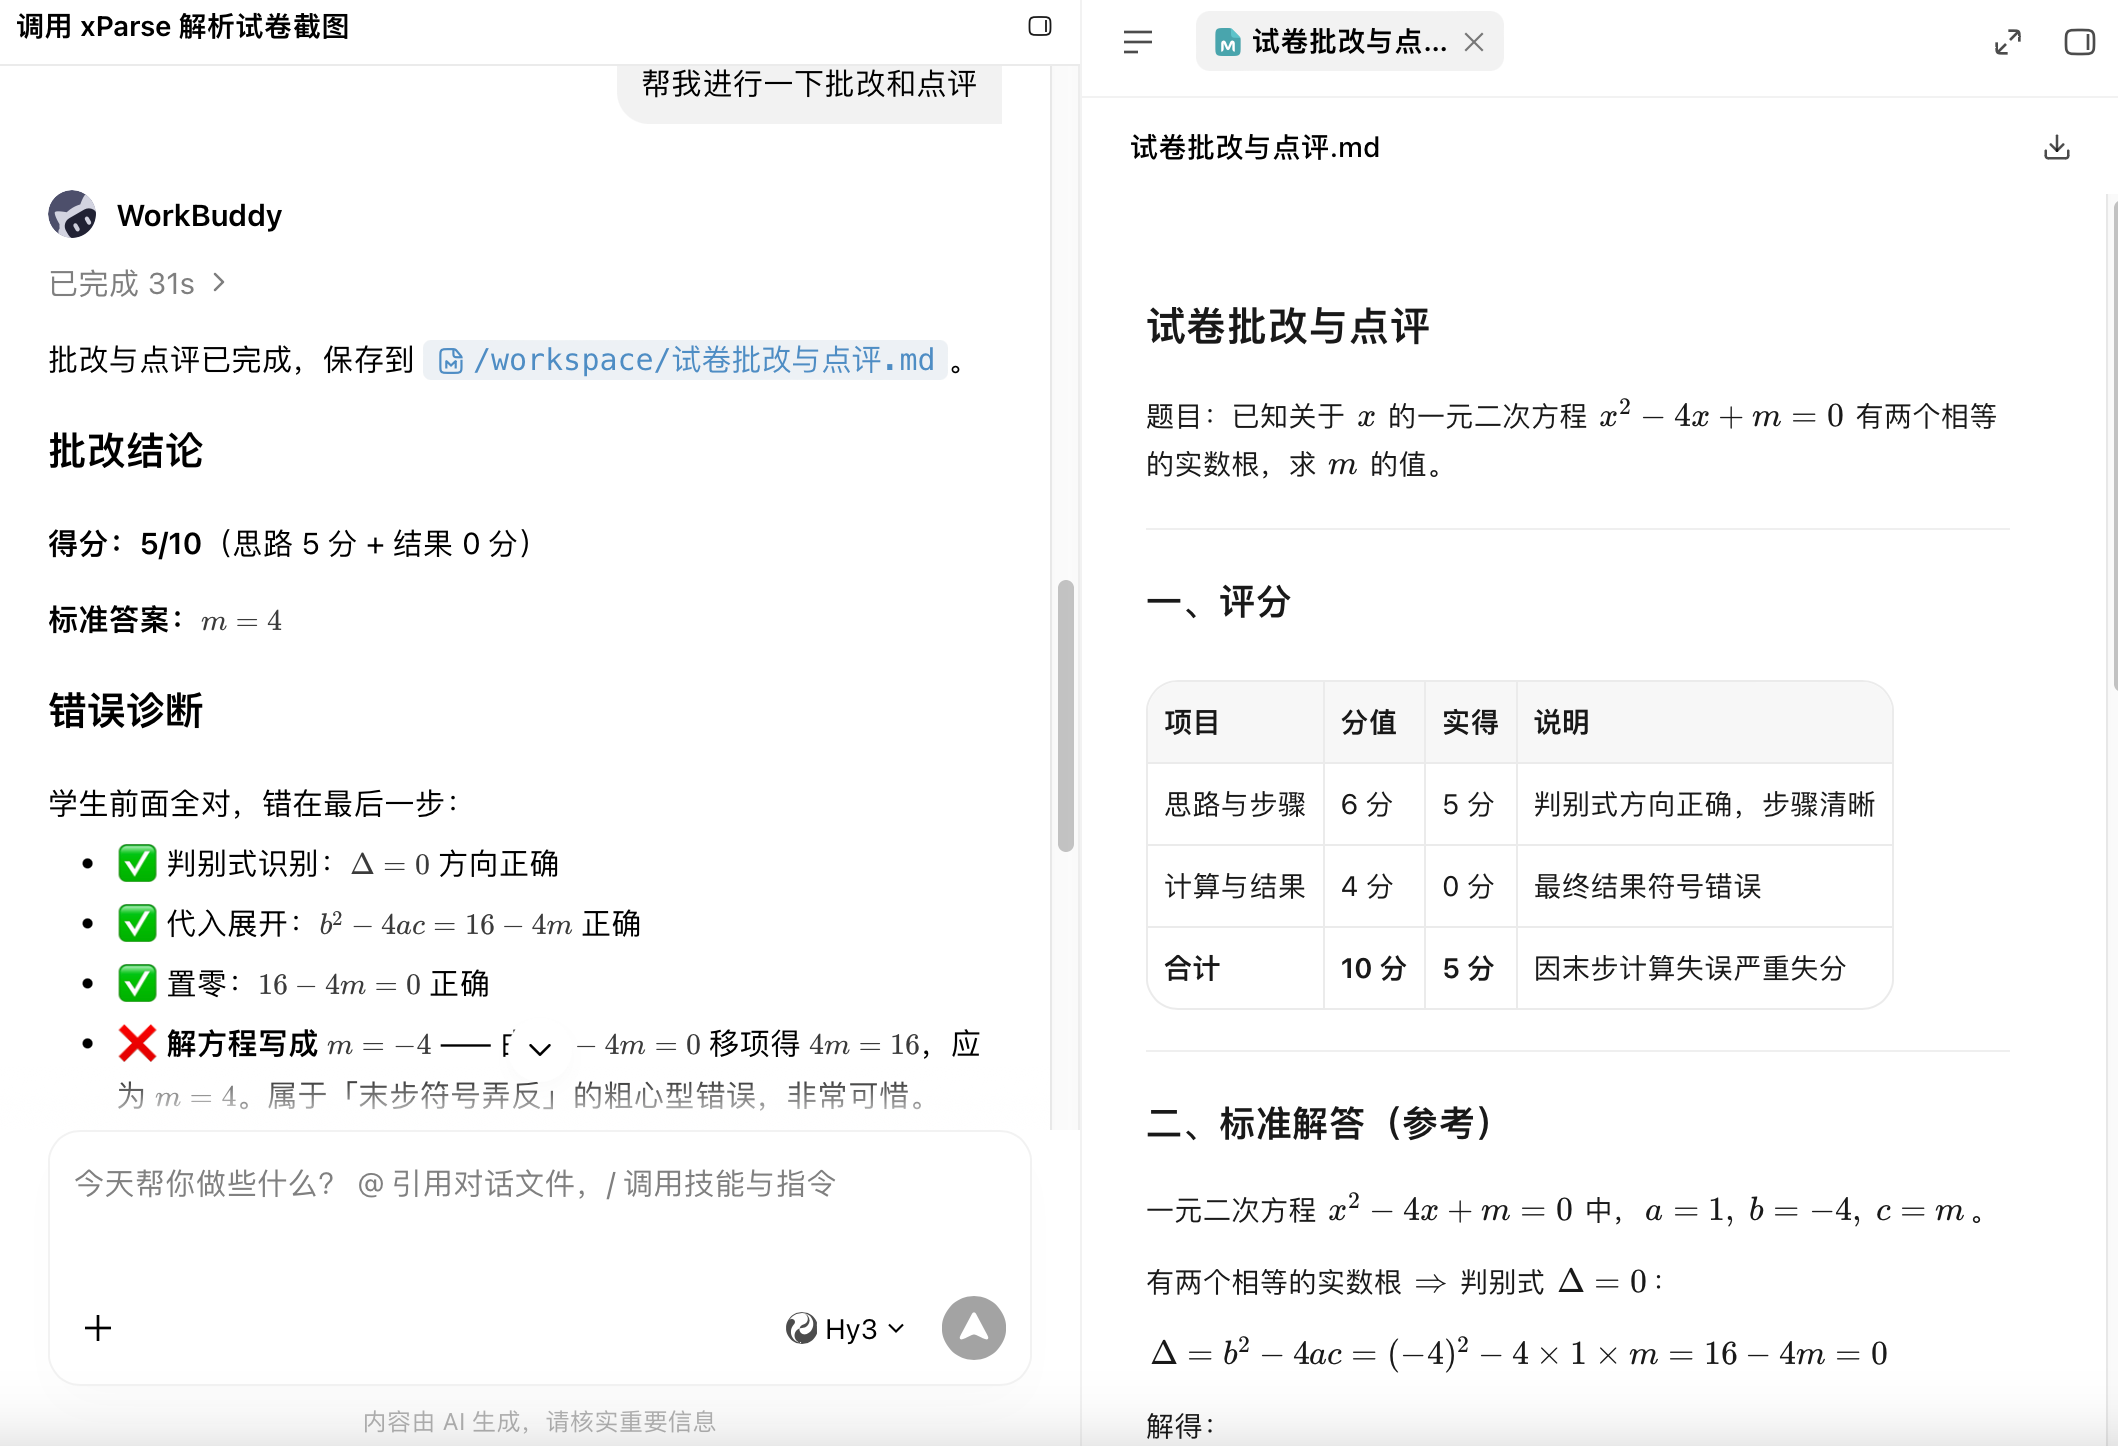
交给上层大模型,得到批改结果:
批改结论:得分 5/10(思路 5 分 + 结果 0 分)|标准答案 $m = 4$

错误诊断:
✅ 判别式 $\Delta = 0$ 方向正确
✅ 代入展开 $b^2 - 4ac = 16 - 4m$ 正确
✅ 置零 $16 - 4m = 0$ 正确
❌ 解方程符号错误:移项应为 $4m = 16$,得 $m = 4$,学生写成 $m = -4$
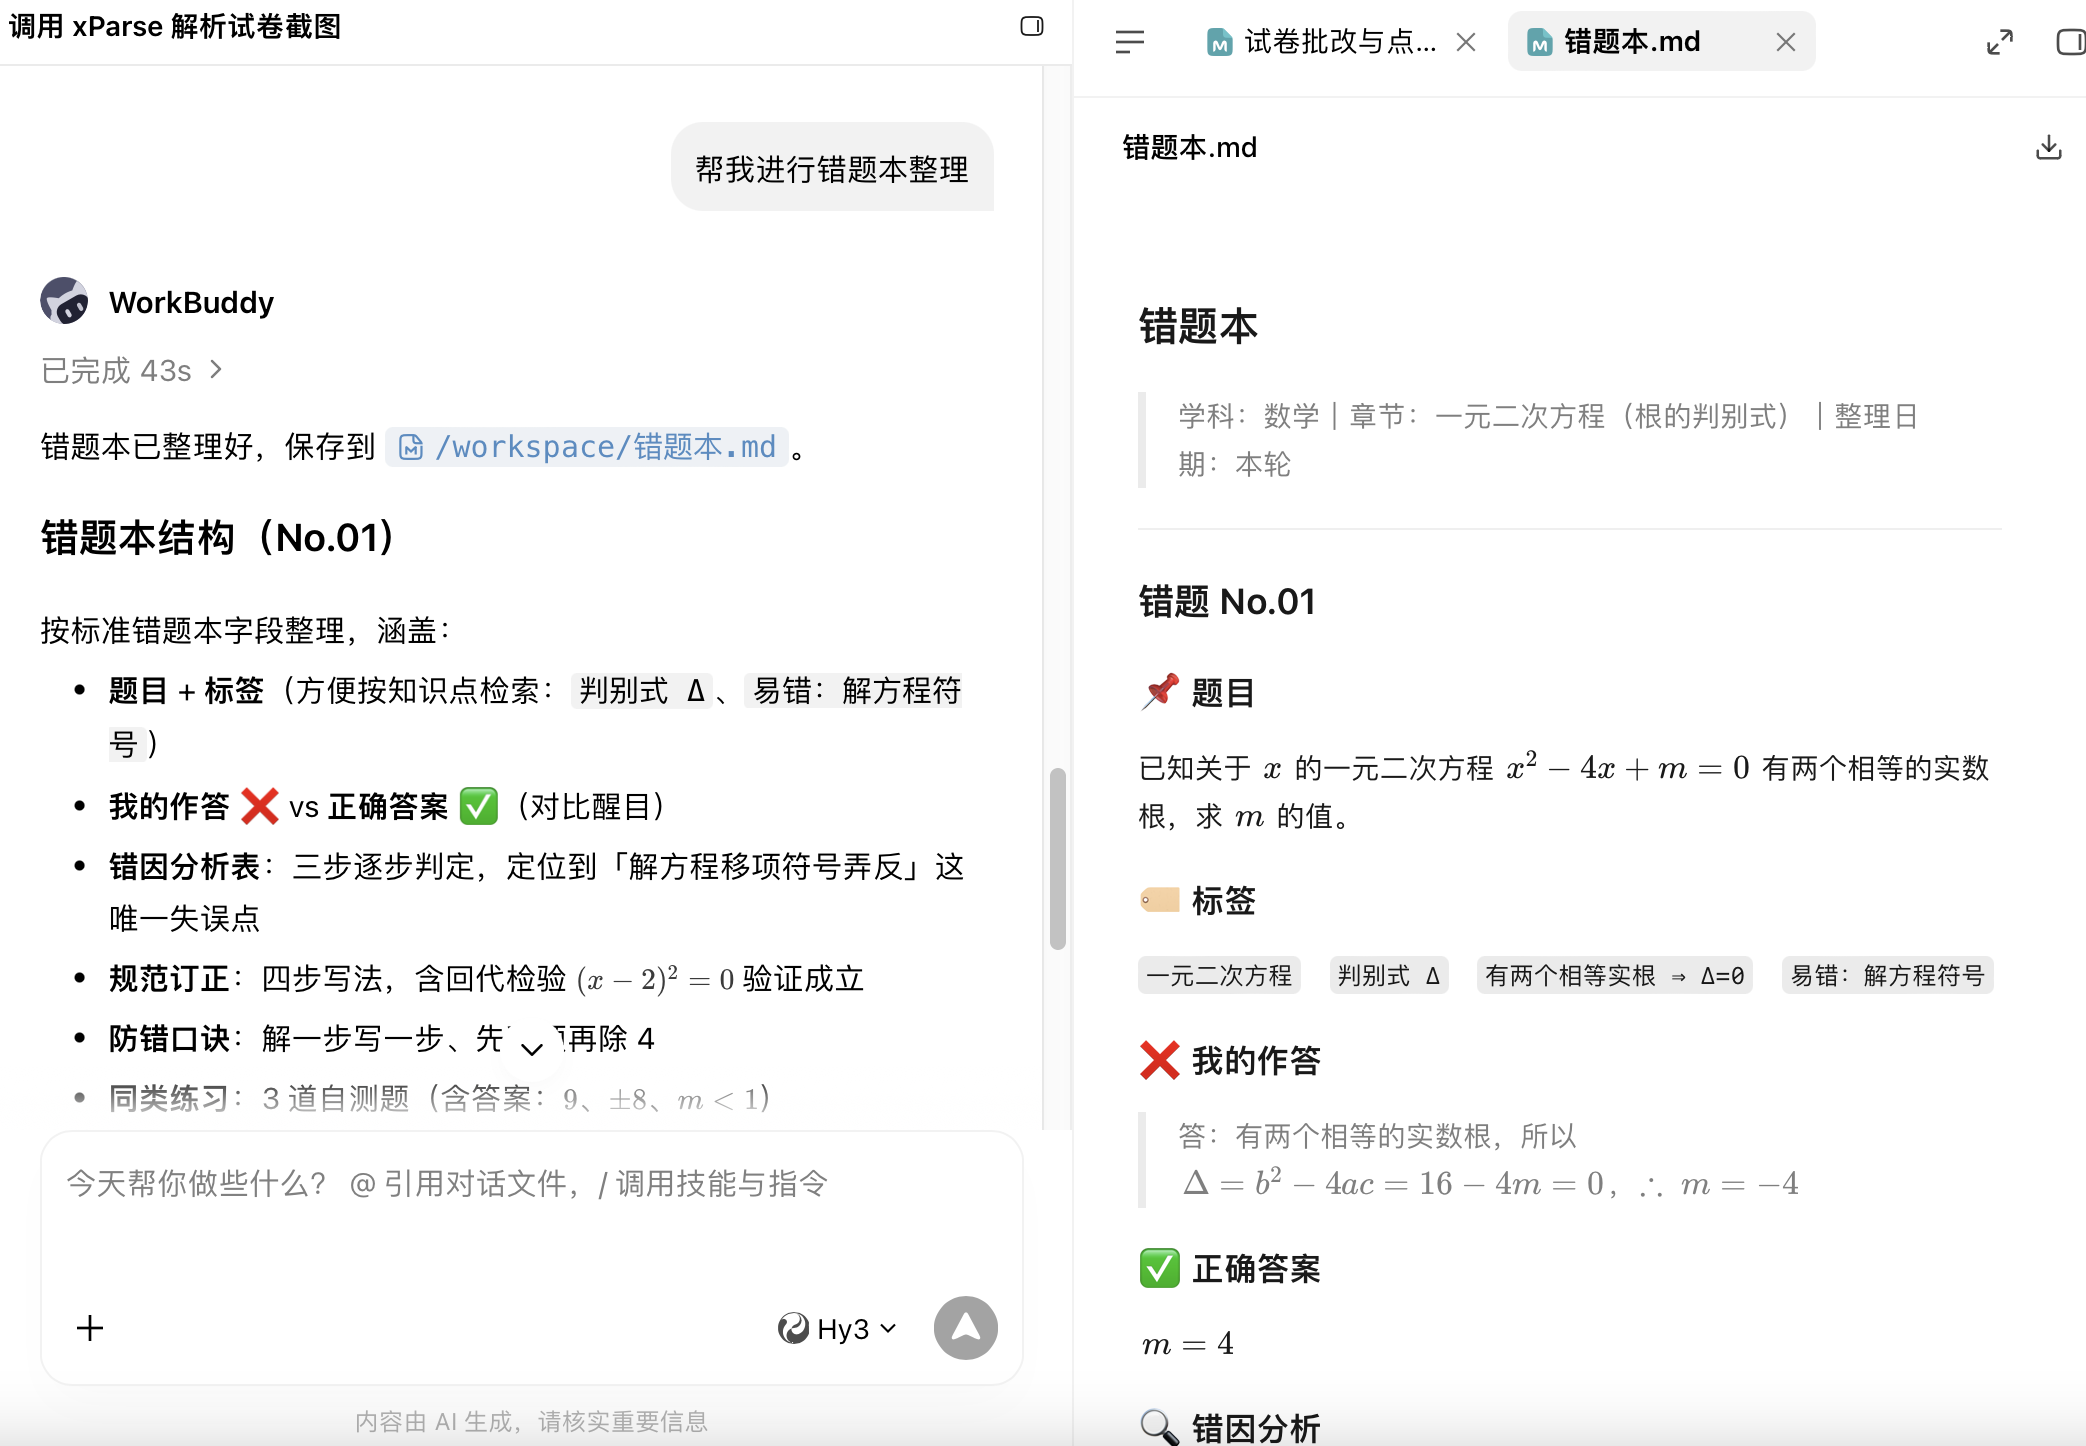
同一道题同时进入错题本整理流程,自动生成如下条目:
【错题本 No.01】
题目:已知关于 $x$ 的一元二次方程 $x^2 - 4x + m = 0$ 有两个相等的实数根,求 $m$ 的值。
标签:一元二次方程 | 判别式 $\Delta$ | 易错:解方程符号
我的作答:$\Delta = b^2 - 4ac = 16 - 4m = 0$,$\therefore m = -4$ ❌
正确答案:$m = 4$ ✅
错因:解方程移项符号弄反
同类练习:3 道自测题
批改与错题本整理同步完成,整个过程从上传到出结果,无需人工录入。这条链路里,xParse 负责“看清”,上层模型负责“理解”,业务系统负责“交付”。
整条链路的关键路径在解析这一步。解析质量决定了批改模型能拿到什么输入,也决定了错题本印出来能不能看。TextIn xParse 在这个链路中的角色,就是确保公式不乱、版面不散、手写不混,让下游的智能批改和错题整理有可靠的基础。