400-6666-582
 更多产品






企业级Agent服务平台选型指南:从需求匹配到场景落地,文档解析工具怎么选?
随着企业 AI 应用从智能问答走向业务流程自动化,企业级 Agent 服务平台正加速连接各类业务系统,推动知识管理、数据处理和业务执行等场景的智能化。然而,企业大量业务信息仍分散在 PDF、PPT、扫描件等非结构化文档中,如何将这些信息转化为 Agent 可理解、可调用的数据,成为实际应用中需要解决的问题。
面对不同客户的文档类型和业务需求,平台厂商在选择文档解析工具时,需要综合考虑多方面因素:既要保证复杂表格、多页文件等内容的解析准确性与完整性,又要兼顾工作流集成、处理性能、数据安全及部署维护成本,以满足不同项目的交付要求。
因此,文档解析工具的价值已不再局限于文字识别,而是进一步延伸至复杂文档处理与业务流程集成。如何从实际需求出发,选择兼顾解析效果、工程适配与落地成本的工具,成为平台提升项目交付效率与服务能力的重要课题。
一、企业级 Agent 服务平台需要的文档解析工具
核心业务场景与应用现状
在企业级 Agent 项目交付中,文档解析需求通常涉及业务单据结构化、知识库构建及复杂技术文档处理。不同场景对解析准确率、文档结构还原和数据输出方式的要求各不相同。
1、业务单据结构化:实现非标文件自动处理
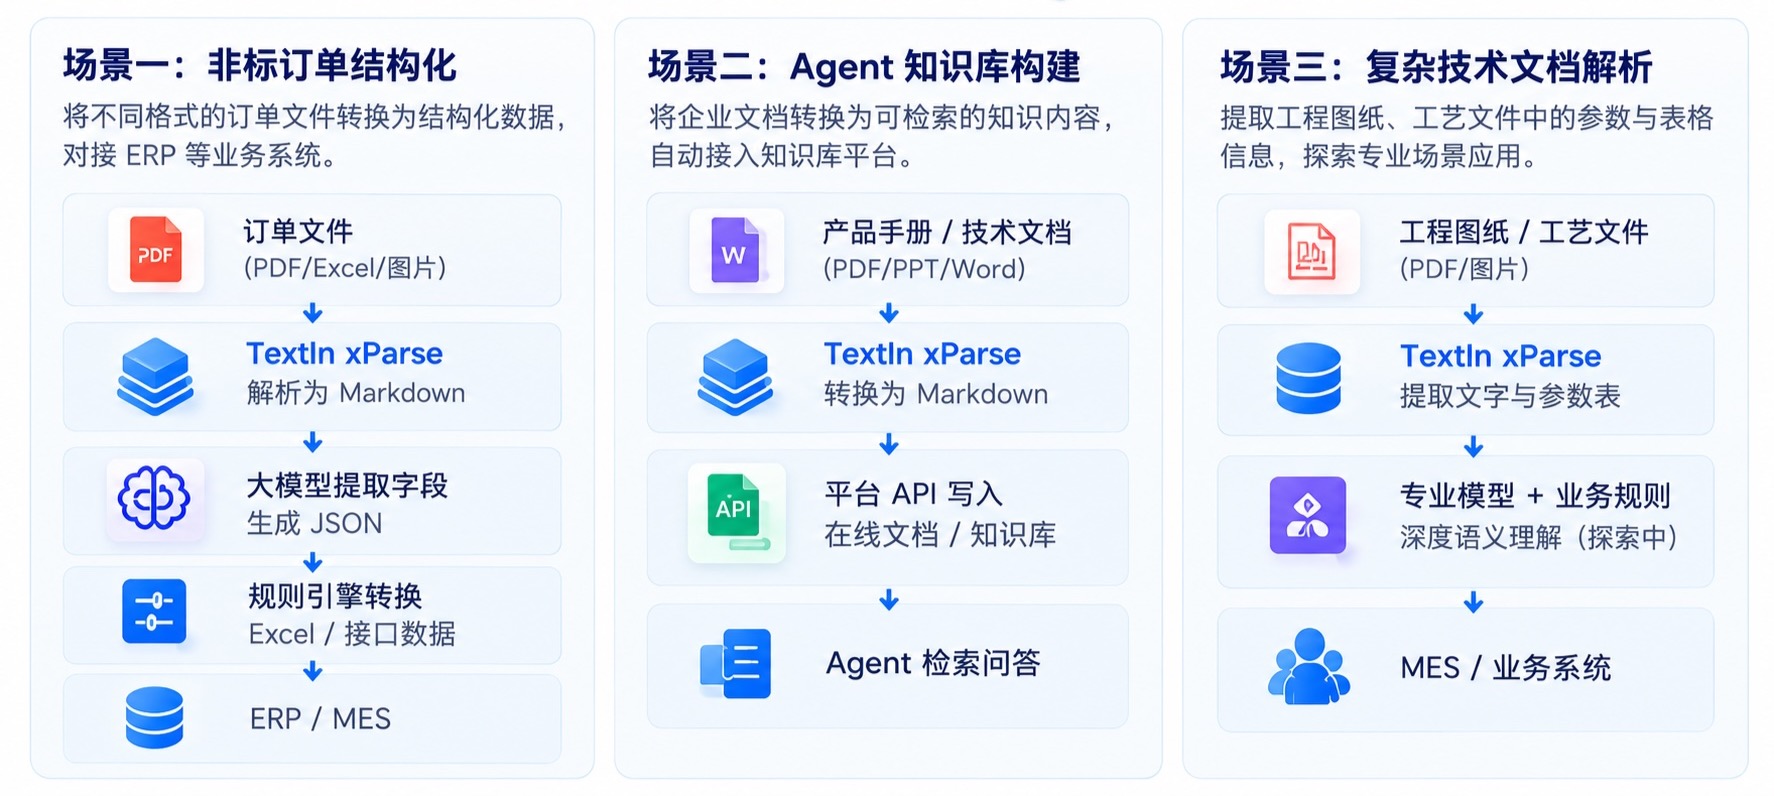
在为制造业、供应链等用户交付 Agent 应用时,平台需要处理大量格式不统一的订单、采购单等文件。通过“文档解析→大模型字段提取→规则引擎转换”,将非标文件转化为结构化数据并对接 ERP 等业务系统,重点关注表格还原、数据完整性及字段准确率。
2、Agent 知识库构建:打通企业文档与知识系统
在为用户搭建 Agent 知识库时,平台需要将产品手册、技术文档等资料转化为可检索的知识内容。例如,通过文档解析工具将 PDF、PPT 转换为 Markdown,再通过 API 接入钉钉等平台,重点关注内容完整性与文档结构还原。
3、复杂技术文档解析:满足行业客户专业需求
在制造业、工程建设等项目中,平台还需处理工程图纸、工艺文件等复杂文档,提取参数、规格及表格信息,对接 MES 等业务系统。此类文档涉及专业符号和复杂图形,除基础文字、表格识别外,深层语义理解仍需结合专业模型与业务规则。
常见文档解析方案及适用场景
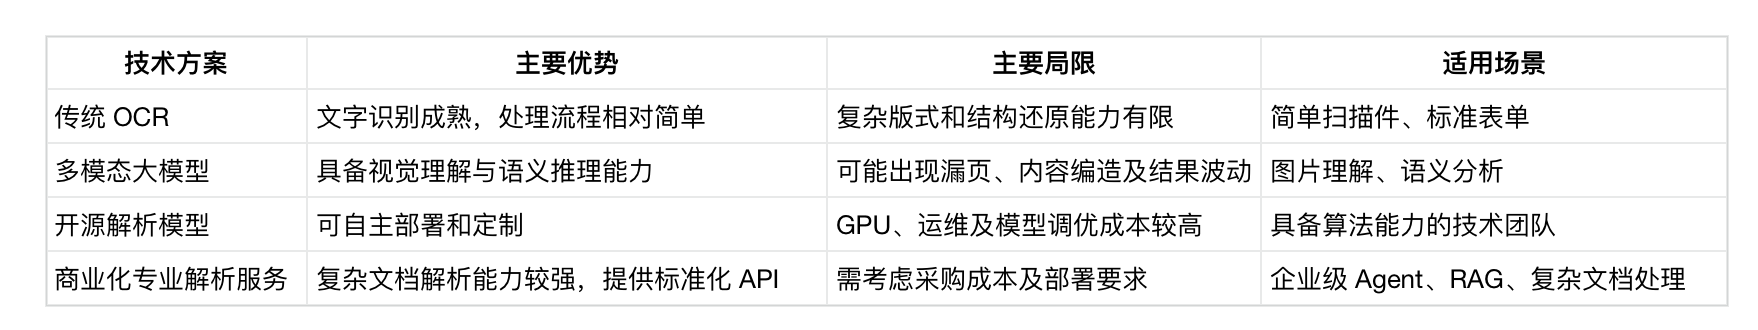
对于企业级 Agent 服务平台而言,不同技术方案并非完全替代关系。多模态大模型适合语义理解与推理,专业文档解析工具则侧重文档内容提取与结构还原。在准确率、稳定性要求较高的业务场景中,将专业解析工具与大模型组合使用,能够更好地兼顾数据处理效果与项目交付效率。
二、企业级 Agent 服务平台选择文档解析工具的核心维度
对于企业级 Agent 服务平台而言,文档解析工具不仅需要满足单个项目的处理需求,还应具备跨用户、跨场景复用的能力。选型时,可重点关注解析效果、工程适配及落地成本三个维度。
解析效果:文档覆盖、结构还原与原文溯源
文档覆盖:能否适应复杂业务文件?企业用户的文档格式多样,既包括常规 PDF、Word、Excel、PPT,也涉及扫描件、拍照文件及多页混合文档。选型时,应关注工具对不同文件格式、清晰度及复杂版式的兼容能力,重点测试多页文档是否完整解析、扫描件是否存在内容遗漏,以及图文混排时的阅读顺序是否准确。
结构还原:能否保留复杂文档的信息关系?对于 Agent 应用而言,文字识别准确并不意味着数据可直接使用。例如,订单表格中的产品名称、数量和交付日期必须保持正确对应关系。一旦出现行列错位,即使文字识别无误,也可能导致后续大模型提取错误数据。因此,平台需要重点验证合并单元格、跨页表格、手写文字、勾选符号等复杂元素的识别效果,确保解析结果能够支撑后续业务处理。
原文溯源:能否支持数据核验?在合同审核、订单录入等高准确率场景中,平台还需要对 Agent 提取结果进行核验。文档解析工具如果能够保留页码、文本位置及表格结构等信息,就能帮助平台快速定位原始内容,建立“解析—校验—复核”的处理机制,降低错误数据进入业务系统的风险。
工程适配:平台集成、性能稳定与安全部署
标准化接口是平台集成的关键。 企业级 Agent 平台通常需要连接不同大模型、知识库及业务系统,因此,文档解析工具应提供标准化 API,并支持 Markdown、JSON 等输出格式,便于嵌入现有工作流,实现文档解析、字段提取及业务数据流转。
处理性能影响 Agent 的整体效率。 面对百页级合同、招投标文件及批量订单等任务,平台需要综合评估长文档处理速度、并发能力与服务稳定性,避免文档解析成为 Agent 工作流中的性能瓶颈。
安全部署关系到企业级项目交付。 对于涉及合同、财务数据及内部技术资料的用户,平台还需关注数据传输、存储安全及访问控制,并根据实际需求评估私有化部署能力与维护成本。
落地成本:真实场景验证与总体成本评估
真实业务样本是效果验证的依据。 不同行业客户的文档差异较大,平台需要使用实际订单、合同及知识库资料进行测试,重点评估字段准确率、内容完整性和结构还原效果,而非仅依赖标准化演示样本。
总体成本比单次调用价格更值得关注。 开源方案需要承担 GPU 资源、模型部署及维护成本;商业化服务则需综合评估调用费用、服务稳定性与技术支持,同时考虑识别错误带来的人工复核及返工成本。
可复用性决定长期交付效率。 对于需要持续服务不同行业用户的 Agent 平台,具备统一接口、稳定输出和灵活集成能力的解析工具,更有利于减少重复开发,降低项目交付与后续维护成本。
三、文档解析工具:TextIn xParse 的专业解答
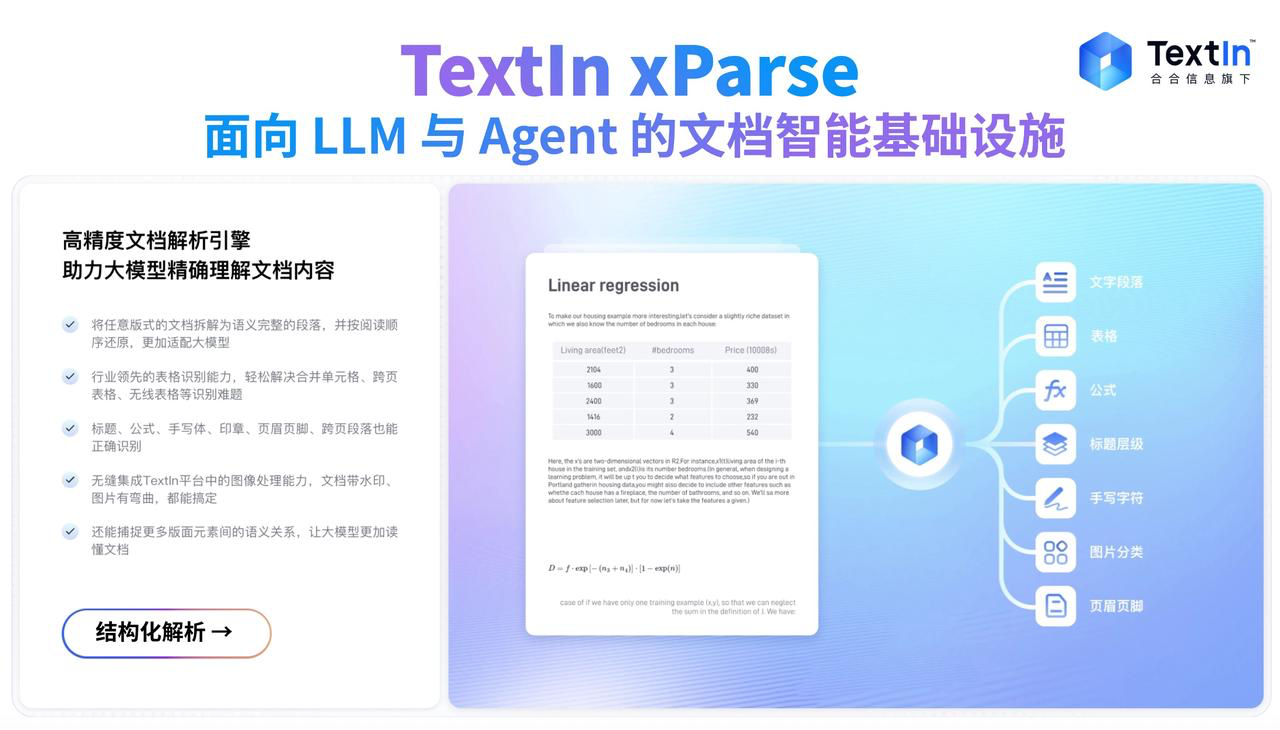
面向企业级 Agent 平台的复杂文档处理需求,合合信息推出的 TextIn xParse 提供多格式文档解析、复杂结构还原及标准化数据输出能力,可通过 API 集成至 Agent 工作流和 RAG 知识库,为平台提供可复用的文档解析组件。
核心能力如何匹配平台选型需求
1、多格式解析与复杂结构还原
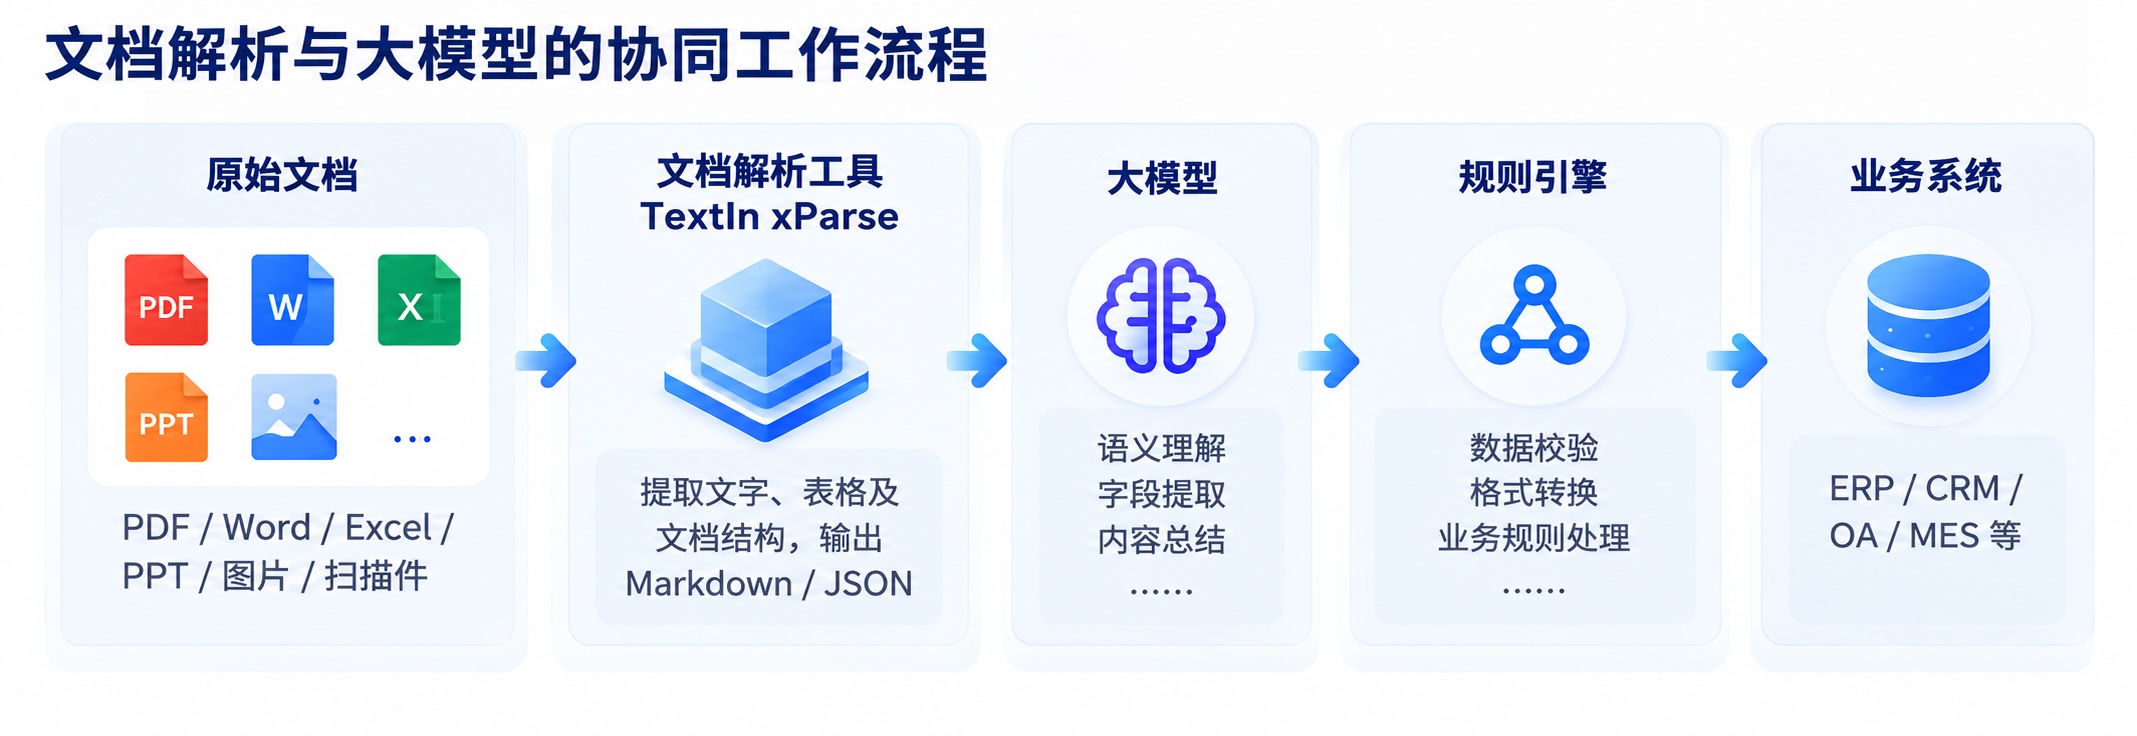
TextIn xParse 支持 PDF、Word、Excel、PPT、图片等多种文件格式,可识别文本、表格、图片、公式等文档元素,并还原标题层级、阅读顺序及复杂表格结构。
面对企业级 Agent 平台多样化的用户文档,xParse 能够为后续字段提取、知识检索及业务流程自动化提供结构化数据基础,减少复杂版式造成的信息损失。
2、标准化输出与 Agent 工作流集成
TextIn xParse 支持 Markdown、JSON 等输出格式,并提供 API 接口,便于集成到企业级 Agent 平台及 RAG 工作流中。
平台可将解析结果交由大模型进行语义理解与字段提取,或将 Markdown 内容接入知识库,支持后续知识切分与检索。通过将文档解析与大模型处理环节解耦,帮助平台灵活适配不同用户需求,提高技术架构的复用性。
3、高性能处理与企业级部署
面对长文档、批量文件及高并发处理需求,解析性能直接影响 Agent 的整体响应效率。
根据 TextIn 官方公布的信息,xParse 百页级 PDF 解析最快可达 1.5 秒,服务可用性达 99.99%,能够为企业级 Agent 平台提供高性能文档解析支持。
同时,TextIn 提供云端服务及企业版产品,平台可根据用户的数据安全要求与业务规模选择合适方案,减少自建 OCR 模型的部署维护成本。
典型 Agent 服务平台场景中的应用与验证
场景一:非标订单结构化,提升业务数据处理效率
在为制造业、供应链等用户交付 Agent 项目时,平台需要将不同格式的订单文件转换为结构化数据,并对接 ERP 等业务系统。
实际项目中,直接使用多模态大模型处理复杂订单,曾出现漏页、日期错误及数据编造等问题。为提高数据处理的可靠性,平台采用“TextIn xParse 解析 Markdown→大模型提取 JSON→规则引擎转换 Excel”的处理链路,将文档解析、业务理解与数据转换分开处理。
这一方案降低了直接依赖大模型生成结果的风险。对于类似场景,TextIn xParse 可作为专业文档解析组件,为后续字段提取提供结构化输入。
场景二:Agent 知识库构建,实现企业文档自动接入
在为用户搭建 Agent 知识库时,平台需要将 PDF、PPT 等非结构化资料转换为可检索的知识内容,并适配不同系统的数据导入要求。
例如,在钉钉生态集成项目中,平台通过 iPass 工作流调用TextIn xParse,将原始文档转换为 Markdown,再通过 API 创建在线文档,供 Agent 知识库使用。
TextIn xParse 的 Markdown 输出及文档结构还原能力,可适配此类知识库预处理需求,帮助平台打通从文档解析到知识导入的自动化流程。
场景三:复杂技术文档解析,探索专业场景应用
在承接制造业、工程建设等行业项目时,平台还可能面临工程图纸、工艺文件等复杂文档的解析需求,需要提取参数、规格及表格信息,并对接 MES 等业务系统。
对于文字说明和参数表格,专业文档解析工具可承担基础信息提取任务。但涉及尺寸公差、几何关系等复杂工程语义时,仍需结合专业模型与业务规则。
TextIn xParse 可用于此类文档的基础解析与结构化预处理,帮助平台逐步探索复杂技术文档的 Agent 应用场景。
企业级 Agent 服务平台的选型没有标准答案,只有最适配业务的方案。欢迎前往TextIn 官网,用你手头最复杂的 10 份 PDF 文档,免费体验 xParse 的解析效果。