400-6666-582
 更多产品






TextIn xParse上架千问办公:为Agent提供企业级解析底座
千问办公的用户,现在可以让你那位“对话即交付”的 AI 同事,真正读懂每一份合同、财报和标书了。
TextIn xParse 已正式接入千问办公连接器生态。在「扩展 → 连接器」中找到 TextIn xParse 并完成授权后,百页 PDF 最快 1.5 秒即可完成结构化解析,每日 1000 页免费额度同步向所有用户开放。
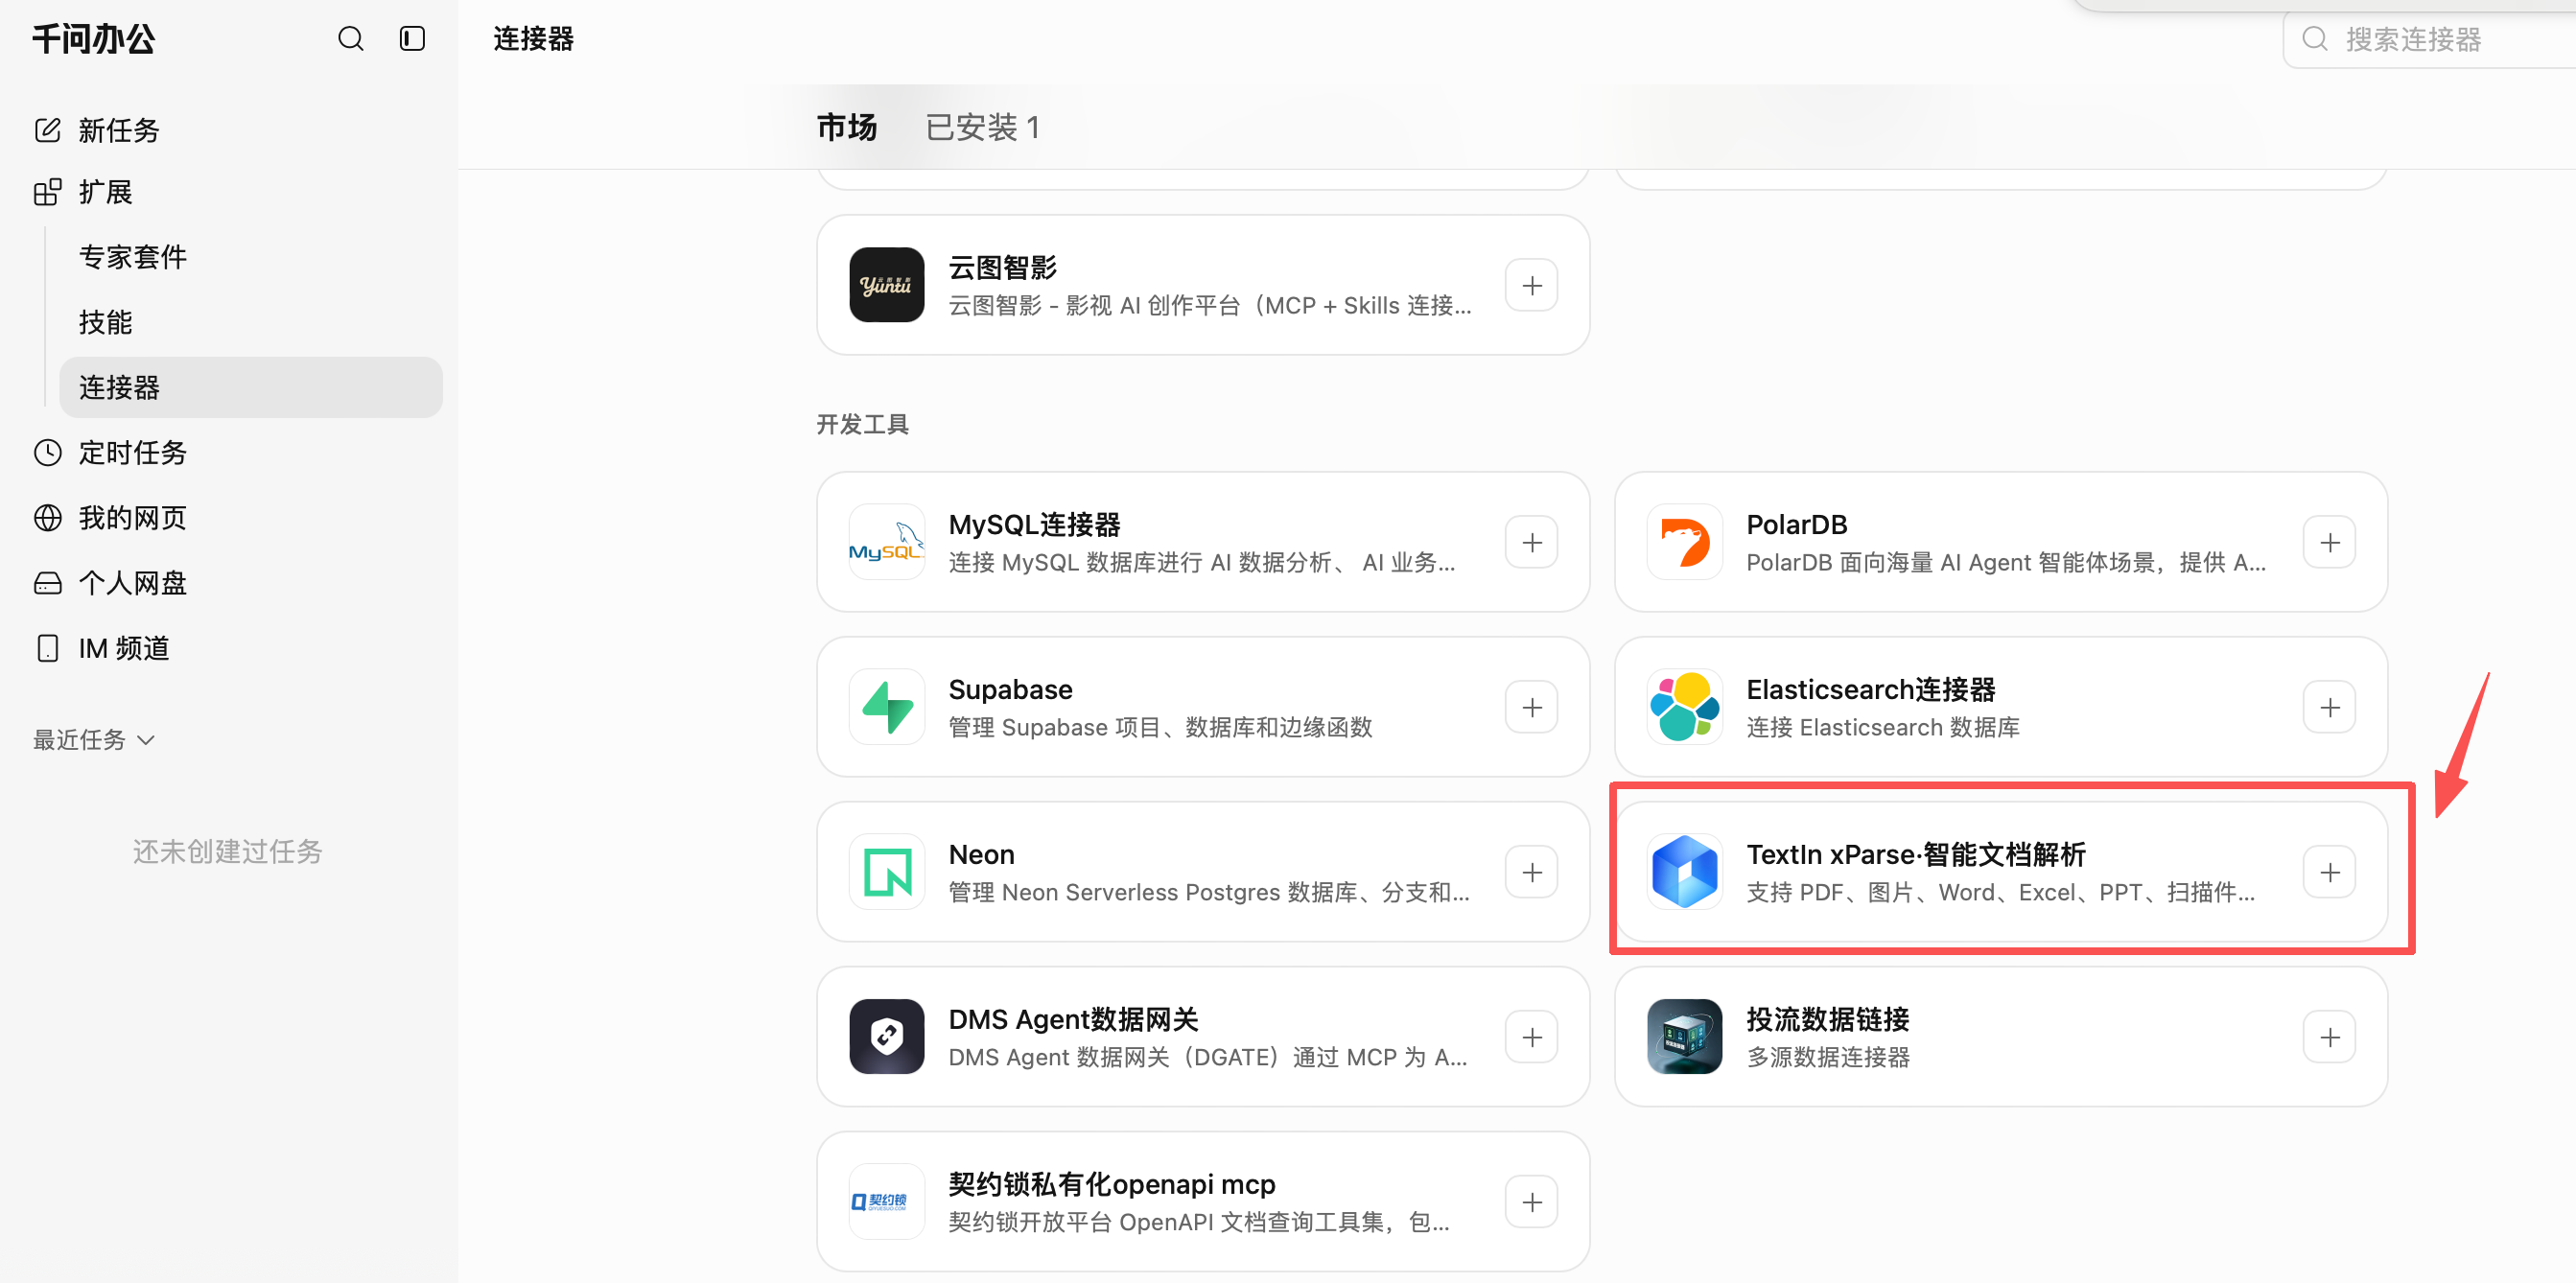
TextIn xParse 帮助 Agent 更好地读懂每一份文档。
01 千问办公:面向企业的一站式 AI 办公平台
千问办公(QwenWork)是阿里巴巴推出的一站式 AI Agent 生产力平台,整合桌面端、云端与企业协同 Agent,深度打通钉钉,支持一句话生成 PPT、Excel、网页、报告等可直接落地的成果。Agent 围绕目标拆解任务、调用工具,最终产出可用的文件、可回写的流程、可沉淀到协作空间里的成果。
千问办公通过“企业上下文”和协作空间,把群聊、文档、知识库压缩、结构化,供 Agent 调用;连接器生态则让 Agent 能跨系统读写数据、触发动作。
在完整的工作流里,高质量的生成永远建立在高质量的读取之上。先把原始文档的结构与数据还原到位,后续产出的内容才能具备扎实的基础。
02 TextIn xParse:把文档从“能看”变成“Agent稳定理解”
TextIn xParse 是合合信息基于 20 年多模态文本智能技术沉淀推出的通用文档解析服务,专为大模型与企业智能应用打造。
随着 Agent 开始进入真实业务流程,文档处理正在成为一个容易被低估的瓶颈。单份普通 PDF 往往可以直接读取,但一旦遇到长文档、扫描件、复杂表格,或需要一次处理几十上百份材料,Agent 就容易出现漏读、结构丢失、结果难核验等问题。要让 Agent 真正可靠地完成复杂文档任务,需要先把原始文档转化为稳定的机器可理解内容。
TextIn xParse 不是简单的 OCR 工具,而是一套完整的文档智能处理体系——将非结构化文档高效转化为结构化、可追溯、可分析的数据资产。
截至目前,xParse 已服务全球超 1000 家企业,单日处理文档量超 百万页,服务可用性达 99.99%,是国内文档智能领域的代表性产品,也是 OpenClaw、WorkBuddy、Dify 等主流 Agent 生态的常用文档解析工具。
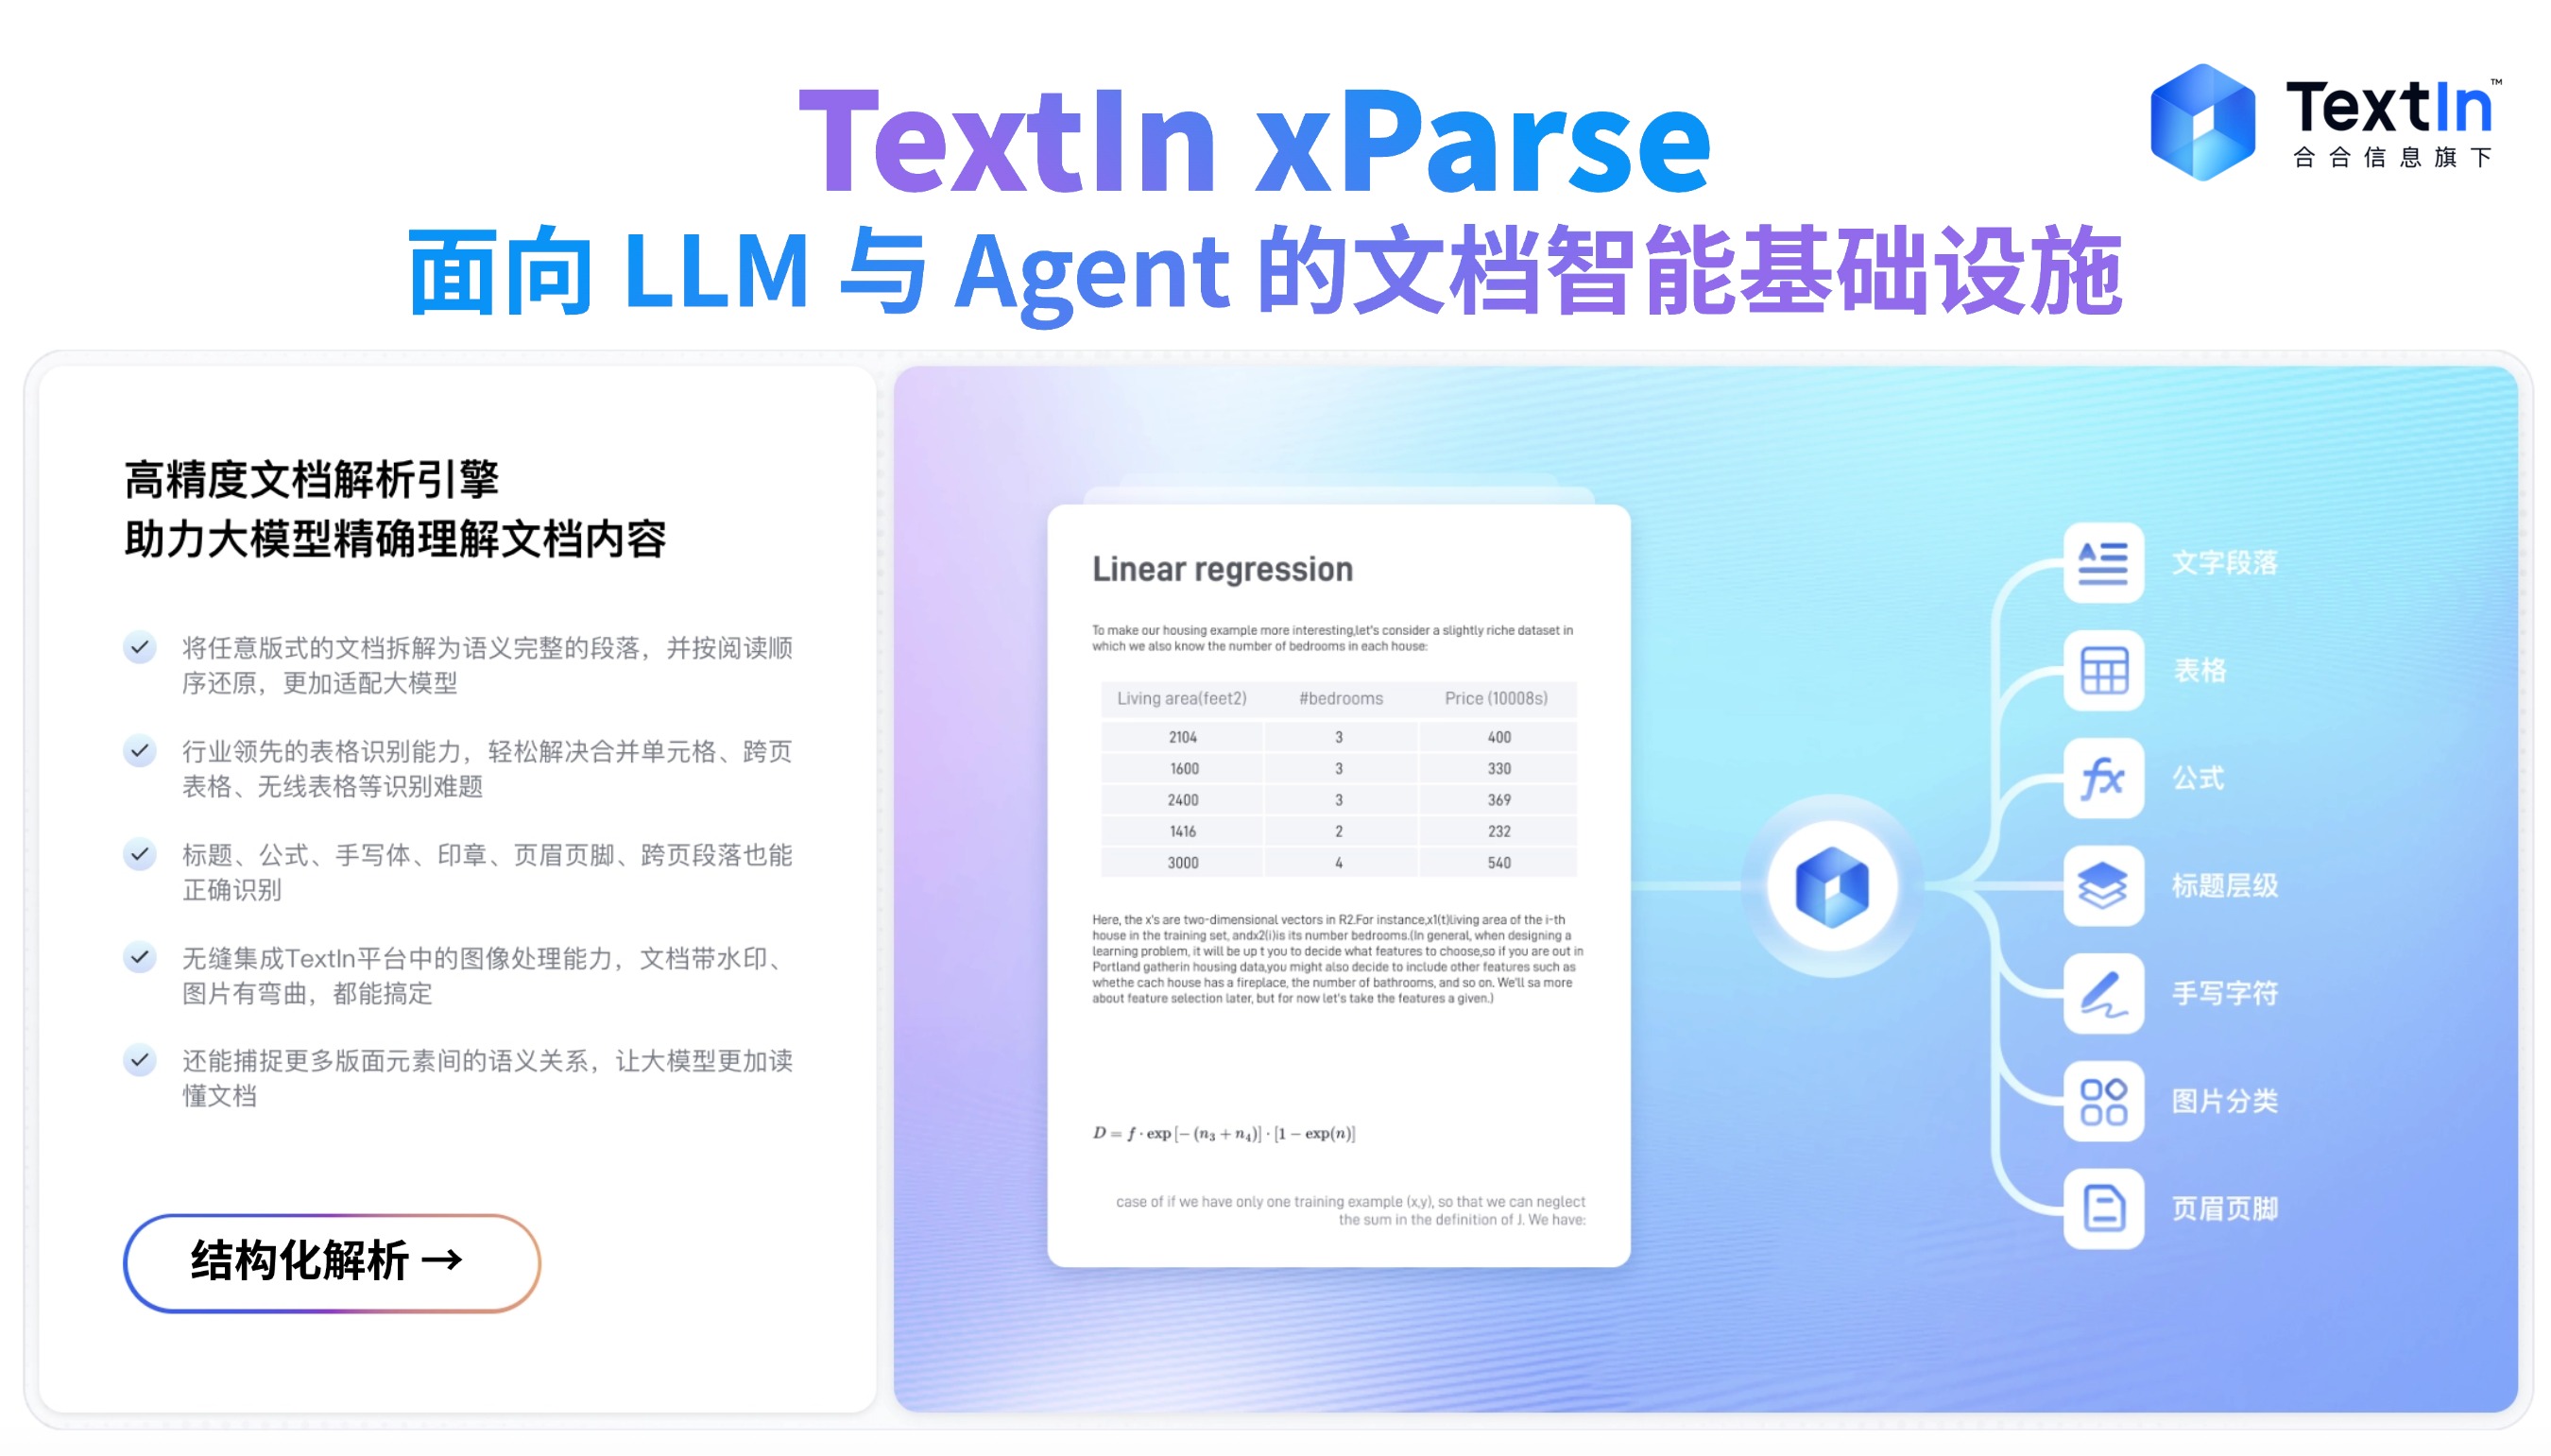
TextIn xParse 核心能力一览
📄 全格式兼容
支持 PDF(含电子档、扫描件) 、Word、Excel、PPT、图片等十余种文件格式。
🧩 深度结构化
精准识别文本、表格、图片、页眉页脚、公式、公章等 16 种内容元素。自动还原标题层级、跨页表格无缝拼接、提取图表坐标轴与数值。
🎯 高精度还原
理解、还原文档结构和元素排列,确保阅读顺序的准确性,针对学术论文、财报、合同标书等多栏排版、图文混排的复杂文档做了专项优化。
🤖 Agent 友好
面向 Agent 的真实文档任务设计,支持长文档、扫描件、复杂表格及多文件批量处理,帮助 Agent 更完整地读取文档、保留原始结构,并为后续信息提取、比对、分析和内容生成提供可靠输入。
⚡ 极速解析
百页级 PDF 文件解析最快 1.5 秒。
📤 标准化输出
解析结果可直接导出为 Markdown、JSON 等格式,方便 LLM、Agent、RAG 及其他下游应用直接消费,无需重复预处理。
🌍 多语言支持
支持简体中文/繁体中文/英文/西欧主流语言/东欧主流语言等 50 余种语言文字识别。
03 xParse 接入后,发生了什么变化?
千问办公原生具备文档处理能力,长上下文也给了它通读百页材料的底气。
但企业场景里的文档,很少是干净的电子版。带水印的扫描版合同、三栏排版的英文论文、跨了四五页的合并报表、图文交错的行业白皮书。基础解析方案遇到这些,容易出现“次序错乱”和“骨肉分离”——左栏文字串到右栏、跨页表格的表头和数据对不上、图表里的关键数值被忽略。
当任务从一份文档变成几十份合同、财报、票据,Agent 还需要知道哪些已经处理、同一信息在不同版本里是否一致、差异在哪一页原文——这些都不是模型推理能补回来的,而是输入质量的问题。
要补上这一层,靠的不是更长的上下文,而是能把文档真正还原成结构化数据的解析能力。xParse 接入千问办公后直接融进平台原有工作流,让千问的三大能力——专家套件、全链路交付、企业空间,可以更好地发挥出实力。
专家套件能直接处理“真实世界的文档”
千问办公里已经上线了“岗位级”专家套件——合同法务专家、企业财税顾问、投研分析师、投行承做助手、私募股权投资……这些套件本身方法论是完整的:合同法务知道怎么按红黄绿分级审合同,投研套件知道怎么从年报里抽财务指标,财税套件知道怎么核对发票和报销规则。
但它们的顺畅工作有个隐性前提:输入得是干净的电子版。
xParse 接入后,这些套件开始能直接处理“真实世界里的文档”:
合同法务套件:面对扫描版 NDA、带公章的采购框架协议、多栏排版的标书,xParse 先把条款层级、签章位置、跨页表格还原干净,红黄绿风险分级和审查初稿直接出;
企业财税套件:手机拍照生成的发票 PDF 直接过,税号、金额、开票日期、明细自动提取,再交给财税套件按公司规则核对;
投研/投行套件:几十上百页的招股书、年报、券商研报,xParse 先还原标题层级、图表数据、跨页表格,再喂给投研套件生成公司深度摘要、可比公司对比表。
专家套件的“大脑”已经准备好了,缺的是一双能看懂复杂文档的“眼睛”。现在,xParse 把最后这块短板接上了。
从“解析成 Markdown”到“直接交付成品 PPT/Excel”
当 xParse 把文档的层级、表格和坐标真正解析到位后,这些高质量的结构化数据完全可以直接用来生成最终的办公成品。在千问办公的全链路交付场景下,xParse 的解析结果可以这样直接跑通到底:
一份 200 页的年报 PDF 丢进来:xParse 解析还原标题层级和财务表格 → 投研套件提取关键指标 → 直接生成一份带图表的 PPT 汇报稿,同时输出一份 Excel 财务模型;
一沓合同扫描件丢进来:xParse 批量解析 → 合同法务套件逐条审 → 直接生成一份 Word 格式的审查意见书,红黄绿风险标注清楚,每条意见后面附原文出处页码;
一沓发票拍照件丢进来:xParse 识别税号金额 → 财税套件核对规则 → 直接输出一份 Excel 报销汇总表,异常项标红。
xParse 是这条链路里的基础环节,决定了后续成品的质量上限。
企业空间:把文档处理能力打包成部门标准
千问办公的企业空间支持:企业内部自行创建专家套件,打包后在部门或全公司分发,“一人配置、全员复用”。
xParse 作为连接器接入后,企业可以把文档处理变成部门标准的一部分。
财务负责人把“xParse 解析 + 发票识别规则 + 企业财税套件 + 公司报销制度”打包成一个“费用审核套件”,上传到企业空间。全公司财务同事一键安装,所有人的 AI 同事都用同一套标准、同一个解析引擎、同一套审核规则处理发票和报销单。
法务部门把“xParse + 合同法务专家套件 + 公司常用合同模板 + 红黄绿分级标准”打包成“合同预审套件”,销售、采购收到合同直接调用,输出的预审意见和法务部出的是同一个口径。
xParse 在这里不再是一个个人工具,而是企业级标准化能力的底座。 千问“专家套件 + 企业空间”生态下,文档智能处理能力可以在企业级应用中放大效率工具属性。
04 怎么开启?三步接入,把复杂文档放心交给千问
上手不需要代码,也不需要额外配置解析工具:
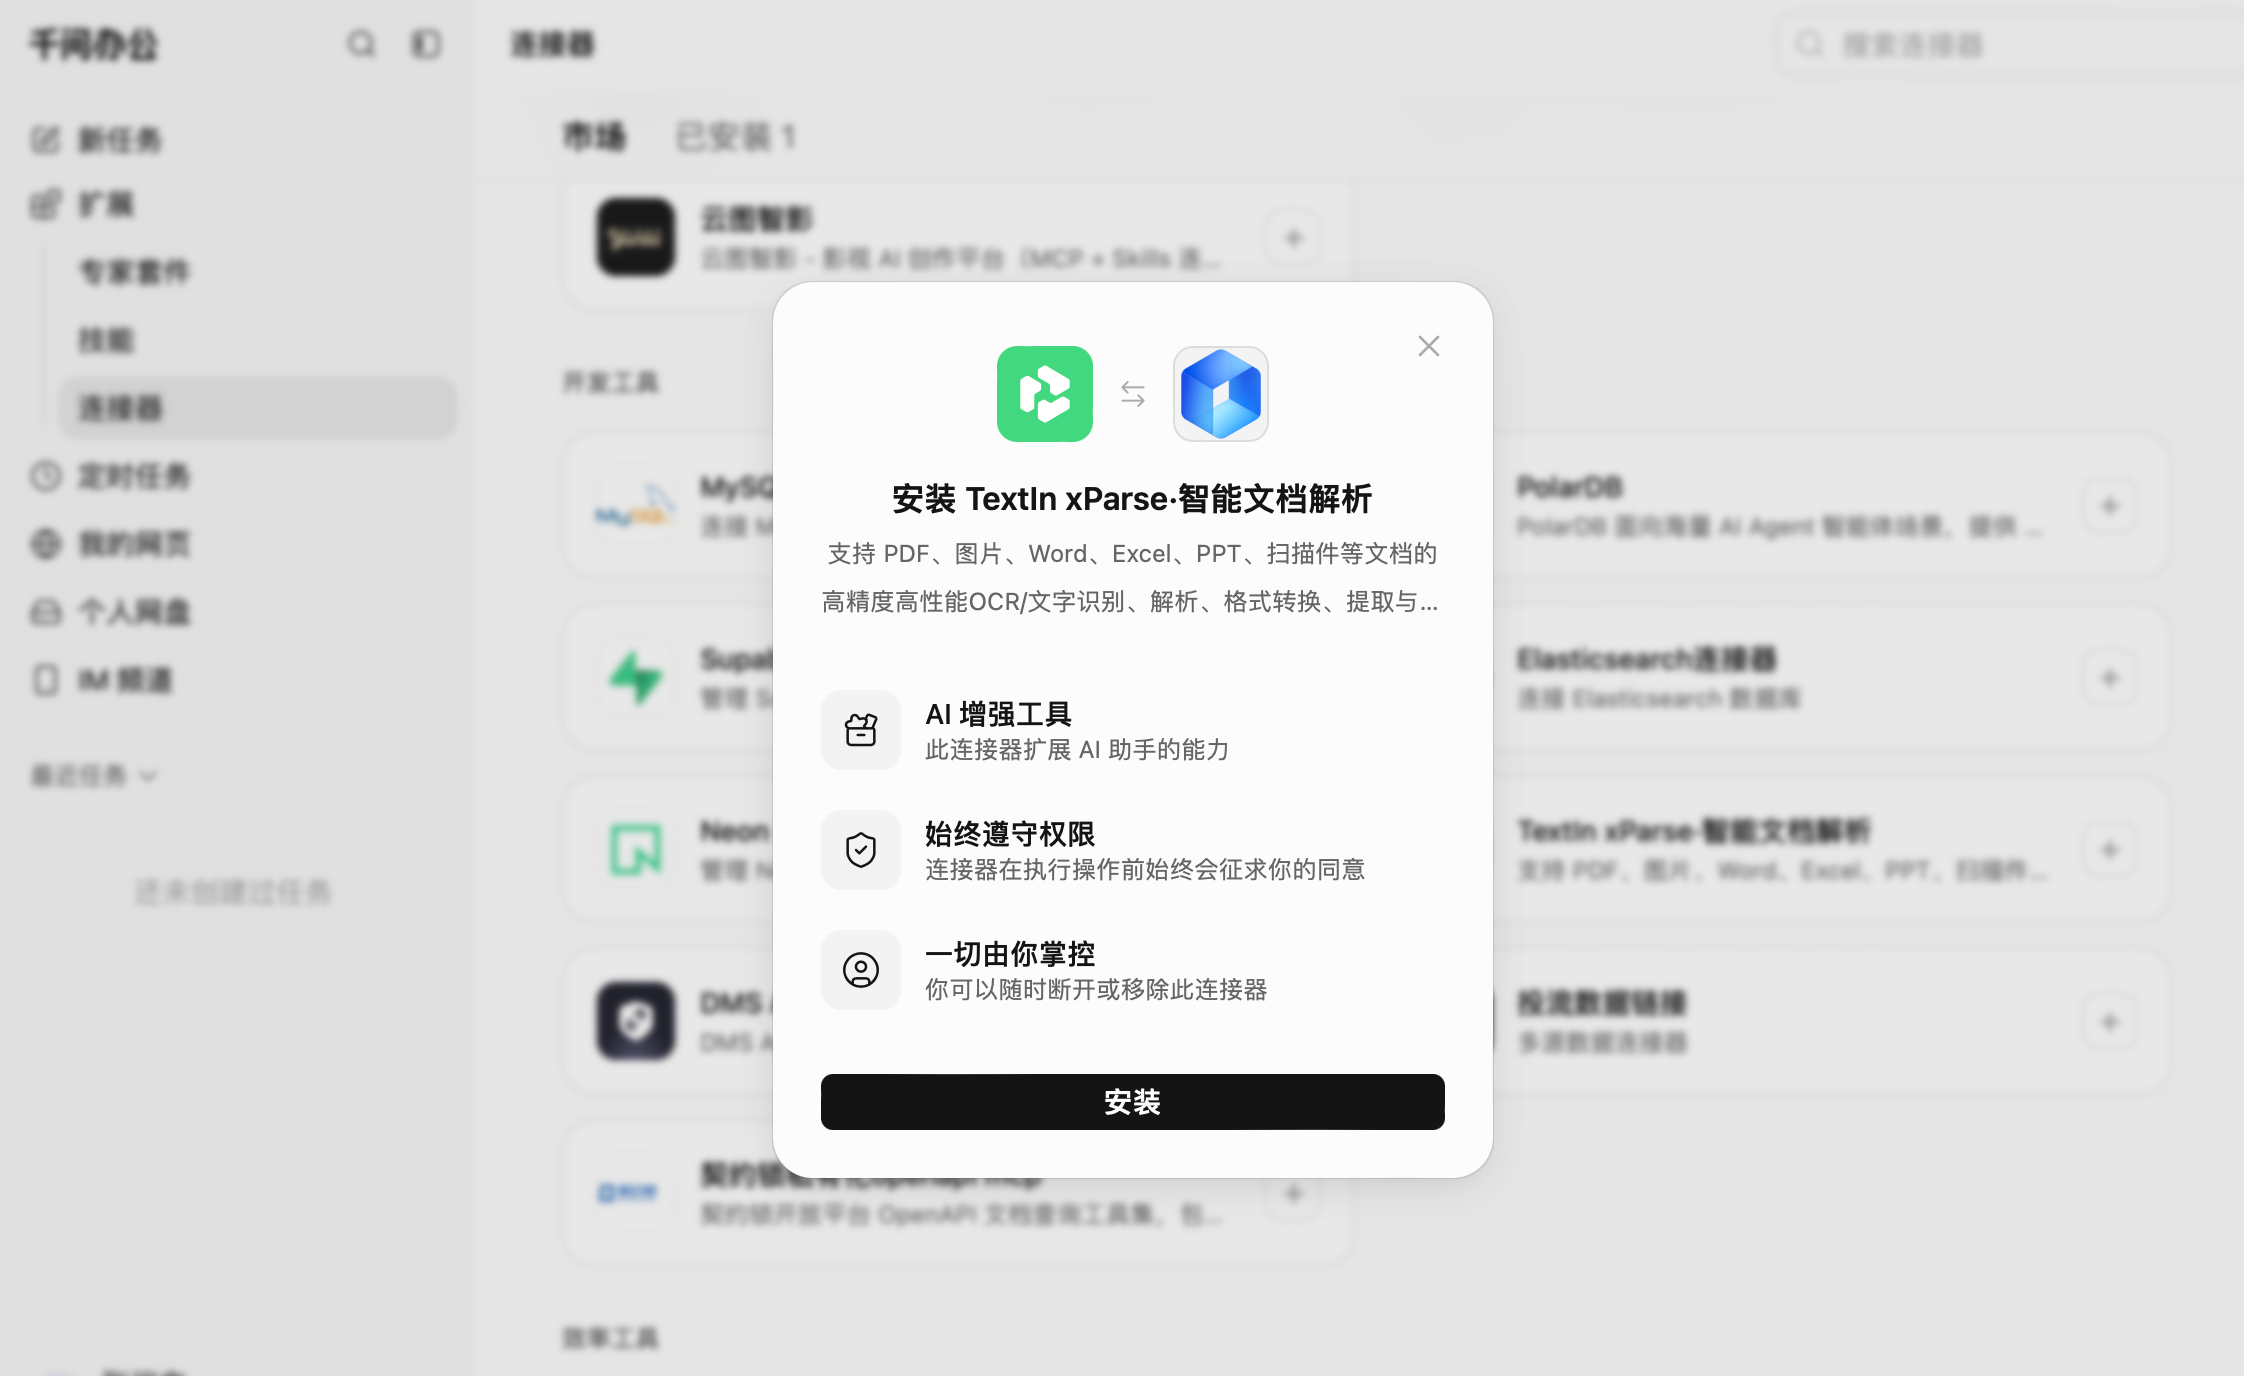
打开千问办公,进入左侧 「扩展 → 连接器」。
在「开发工具」找到 TextIn xParse 或直接搜索,点击安装并完成账号授权。
在对话或任务中上传文档,直接用自然语言描述目标。
可以直接复制这些指令试试:
“用 xParse 解析这份扫描版合同 PDF,调用合同法务专家套件,按红黄绿三级出一份风险预审意见,输出 Word。”
“把这沓拍照版发票用 xParse 识别,提取税号、金额、开票日期,交给企业财税套件核对报销规则,输出 Excel 汇总表。”
“用 xParse 读这份 200 页年报,配合投研分析师套件提取核心财务指标和前五大客户,直接生成一份 PPT 汇报稿。”
“桌面这个文件夹里有 50 份项目文档,用 xParse 批量解析后按项目归类,生成一份可检索的 Markdown 知识库。”
TextIn xParse 为千问办公用户提供 每日 1000 页解析额度,不需要额外申请,商业级能力零门槛接入。
了解更多: 访问 TextIn 官网 或千问办公官方文档。
下次遇到扫描件读不动、跨页表格对不上、长文档解析到一半截断的情况,先让千问办公调 xParse 试试。