400-6666-582
 更多产品






PDF转JSON/Markdown:如何批量解析复杂文档并保留页面结构?
随着OCR技术的发展,常规文档的文字识别与提取已相对成熟,但面对多栏排版、跨页表格、图文混排等复杂PDF,如何稳定提取内容并保留原始结构,仍是面向AI的文档处理流程需要解决的问题。
仅提取文字并不意味着完整还原了文档信息。在解析过程中,阅读顺序可能错乱,表格行列关系可能丢失,图片与正文之间的关联也可能被破坏,影响后续的数据处理与使用。因此,PDF解析不仅需要识别文字,还需要兼顾版面分析、元素关系识别与结构化输出,将文档转换为Markdown、JSON等便于后续处理的数据格式。
一、通过TextIn xParse实现复杂文档批量解析
TextIn xParse:面向复杂文档的智能解析能力
TextIn xParse是合合信息推出的智能文档解析产品,支持将PDF、Word、Excel、PPT及图片等多种文件格式转化为JSON或Markdown格式,能够识别标题、正文、表格、图片、公式等文档元素,为企业知识库、RAG、AI Agent及业务系统提供文档数据基础。
TextIn xParse提供在线Web平台、API及SDK等接入方式。企业可以通过在线平台查看解析结果,也可以将解析能力集成至现有系统,满足不同的文档处理需求。
通过API实现批量文档自动化处理
在企业知识库入库、历史资料数字化等场景中,文档往往数量较多,单份文件也可能包含上百页内容。
通过TextIn xParse API,企业可以将文档解析能力接入现有系统,结合任务队列提交待处理文件,并在解析完成后获取相应结果。
整体流程如下:
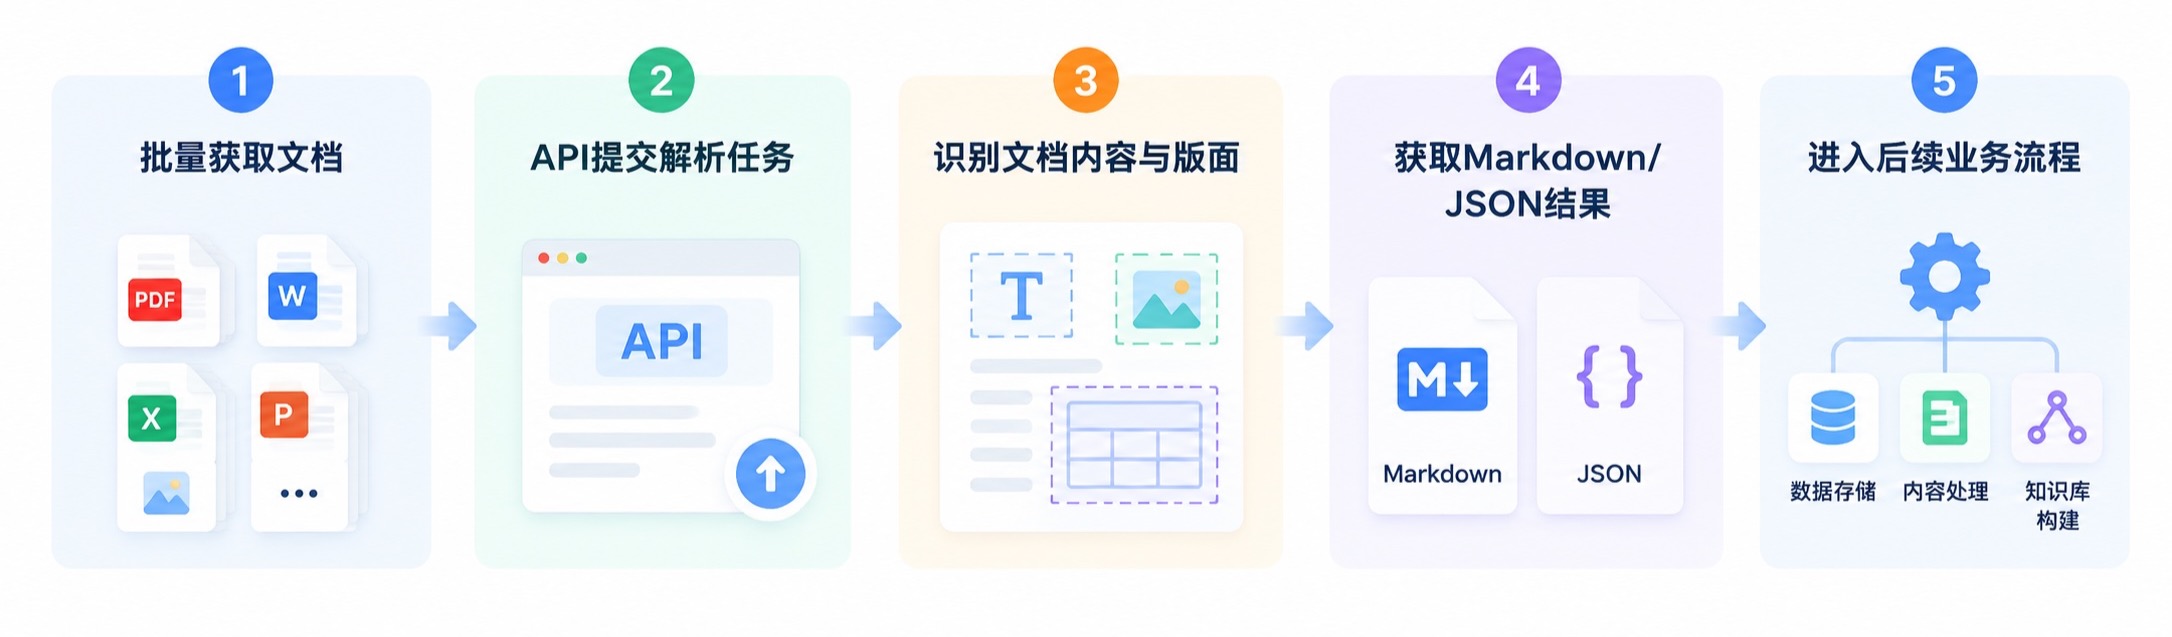
针对长篇文档及批量处理需求,TextIn xParse提供异步解析API。用户可以先创建解析任务,再通过任务状态查询或Webhook回调获取处理进度与完成信息,减少长时间等待同步请求返回的情况。
输出Markdown和JSON,满足各类场景需求
Markdown与JSON格式分别侧重内容组织和结构化数据处理,可以根据业务需求选择或配合使用。
Markdown:组织文档内容,便于阅读与文本处理
Markdown通过标题、段落、列表和表格等形式组织内容,适合将PDF中的信息转换为便于阅读和处理的文本结构。例如,产品技术说明书中的功能介绍和技术参数,可以按照标题、正文和表格等形式组织。
对于知识库建设、文本检索和大模型内容处理等场景,Markdown便于进一步开展内容清洗、文本切片和索引构建。不过,Markdown主要保留内容的逻辑组织,并不等于完整复制PDF的视觉布局。
JSON:保留结构化信息,便于程序化处理
JSON能够承载更丰富的文档解析信息。TextIn xParse解析结果采用结构化Element模型,可通过elements列表返回不同类型的文档元素,并提供文本、页码、坐标等相关信息。
例如,一份设备技术手册可能同时包含说明文字、操作示意图和产品参数表。通过JSON中的元素类型,可以识别不同内容区域;结合页码和坐标信息,还能定位原始PDF中的对应位置,为后续的数据提取和内容追溯提供依据。
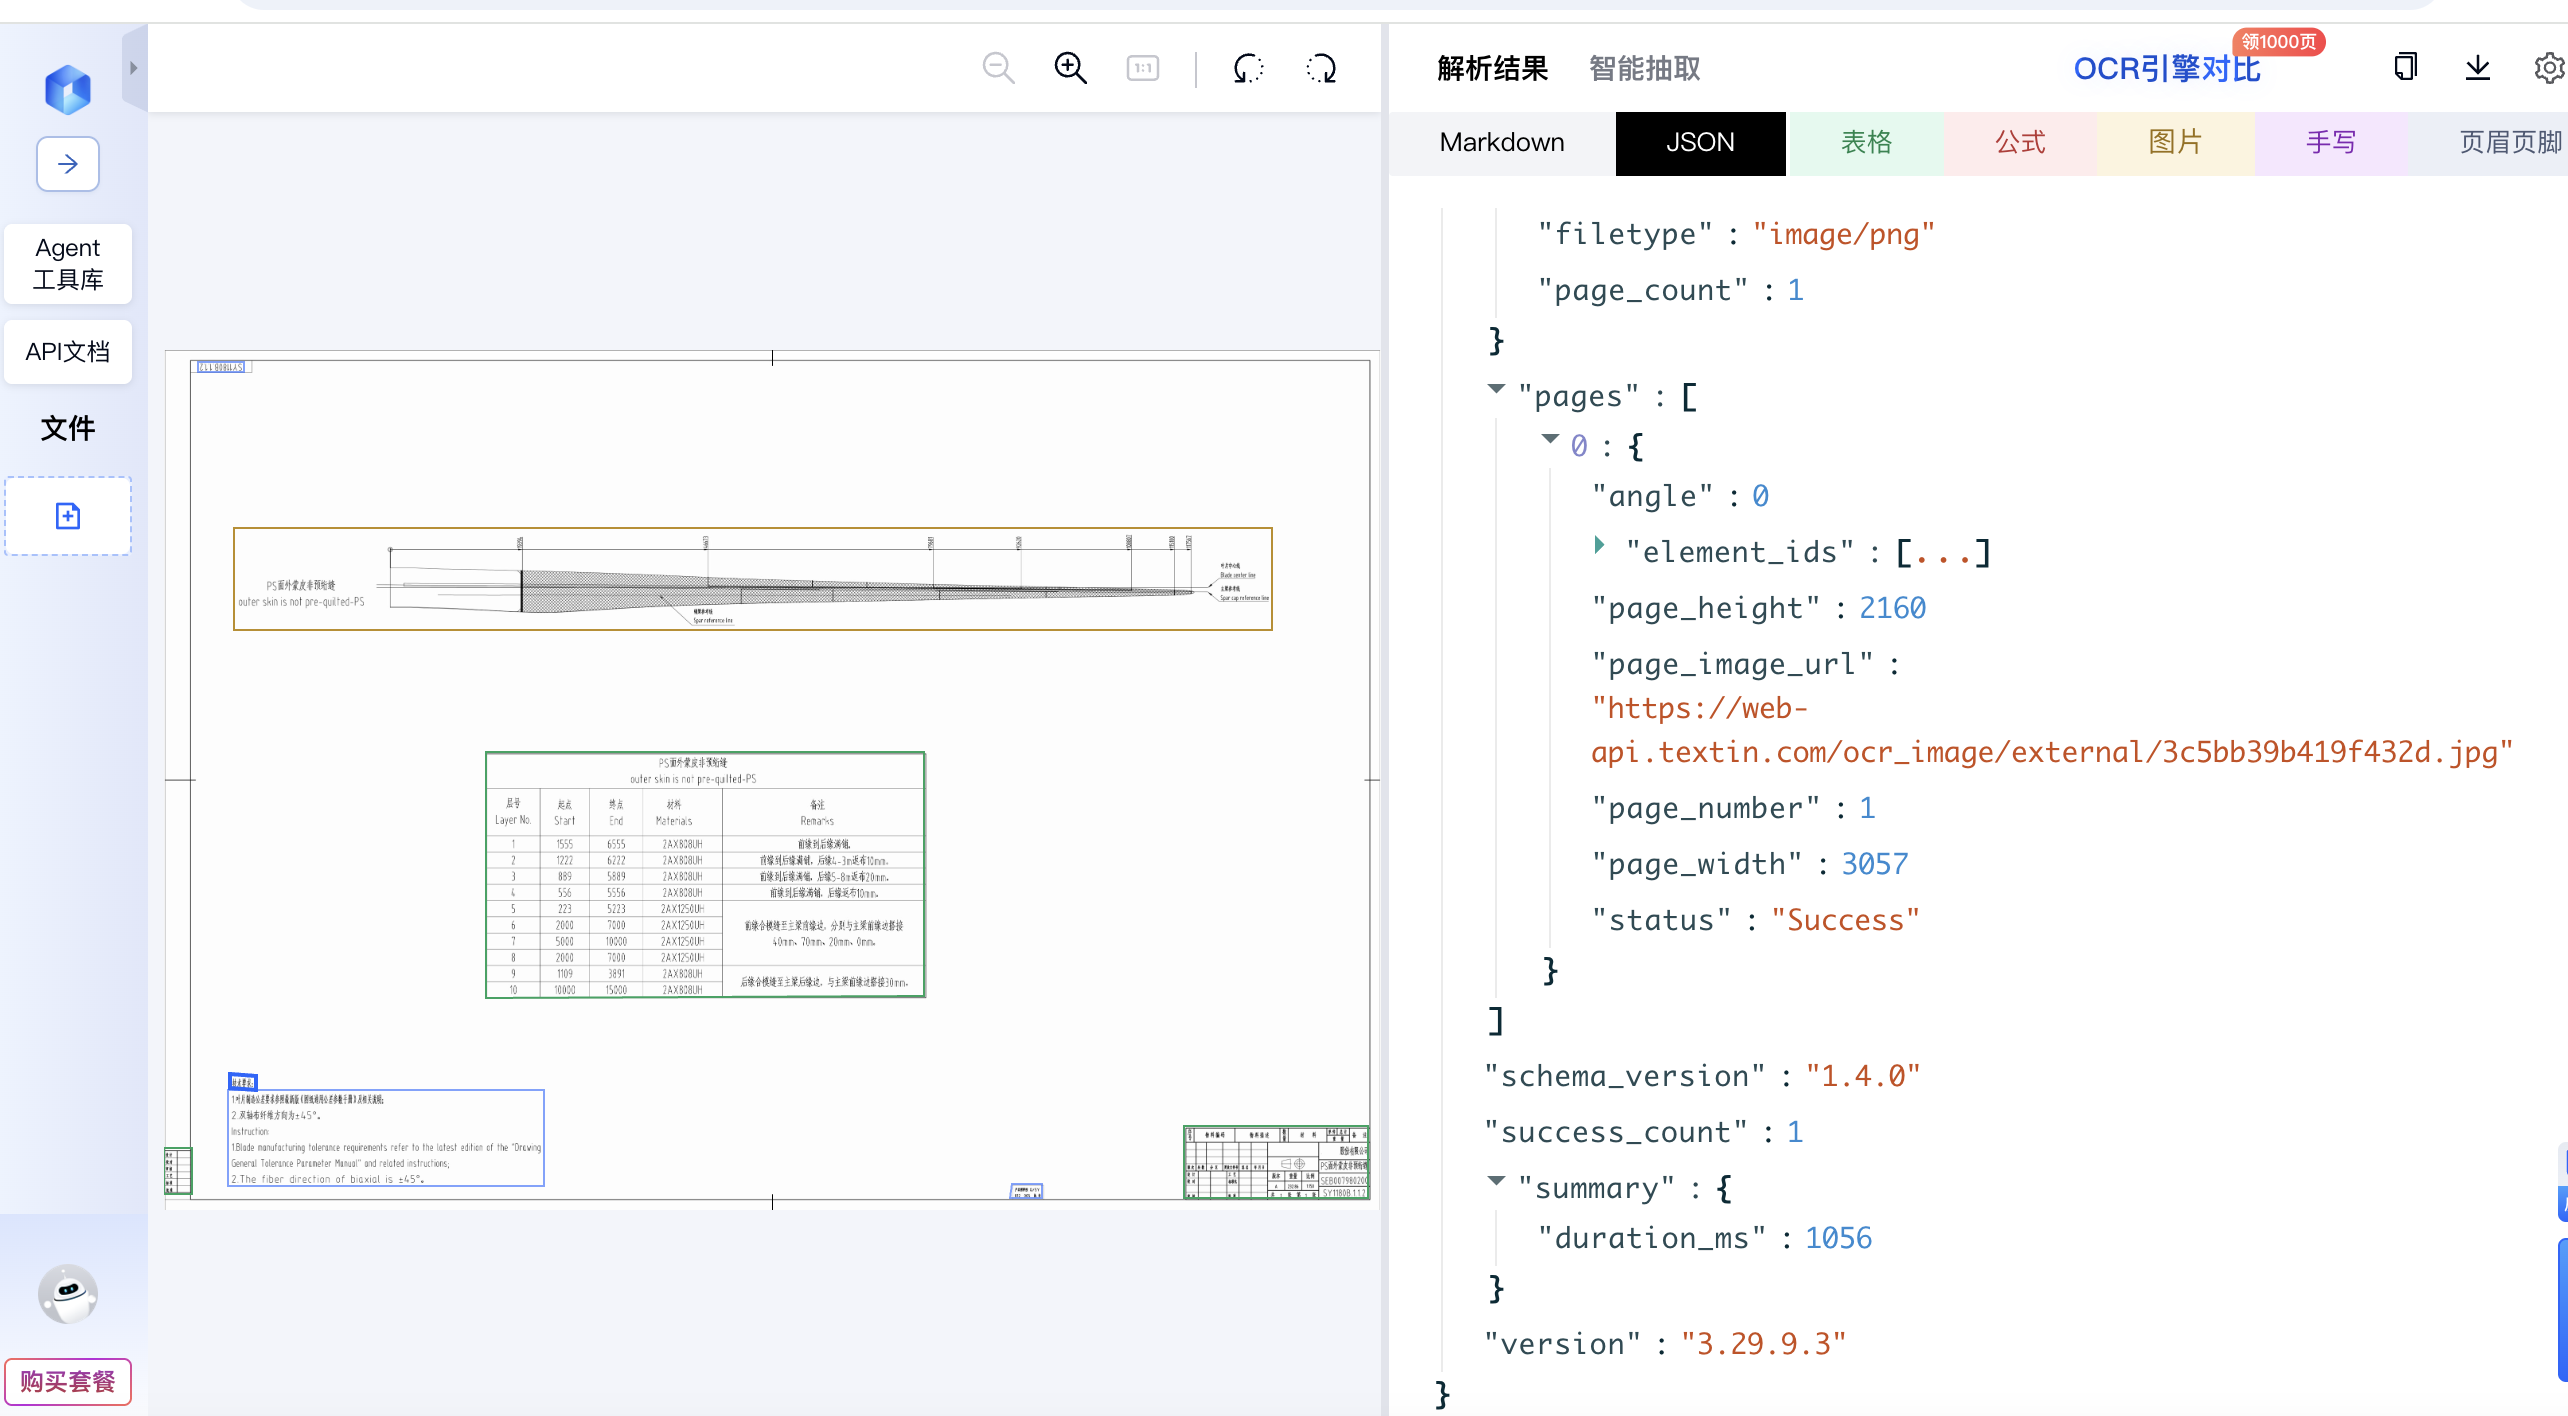
例如,业务系统需要从设备技术手册中提取参数,可以结合元素类型识别表格内容,再利用页面信息定位原始文档中的对应区域。Python SDK示例介绍了如何通过result.markdown读取Markdown内容,并使用result.model_dump()获取可保存为JSON的完整解析结果。
Markdown适合内容阅读和文本处理,JSON则更适合元素识别、页面定位及后续程序化处理。两者配合使用,可以兼顾内容可读性与结构化处理需求。
二、复杂文档解析后,如何保留页面结构?
对于多栏排版、复杂表格和图文混排的文件,还需要关注原始页面中的阅读顺序、元素关系及位置信息。
TextIn xParse通过版面分析和结构化输出,为这些信息的识别与后续处理提供支持。
还原多栏排版与文档阅读顺序
学术论文、行业报告和技术手册常采用双栏或多栏排版,页面中还可能包含标题、正文、页眉页脚及图片说明等不同元素。若仅按文字位置提取内容,容易出现跨栏内容交错、段落顺序错乱等问题,影响文档内容的完整性与可读性。
针对复杂版面,TextIn xParse通过版面分析识别标题、正文等文档元素,并结合页面布局组织解析结果,帮助区分不同区域的内容及其阅读顺序,减少多栏内容交错和段落错位,使输出文本更符合原始文档的阅读逻辑,为后续的文本检索、内容切片和信息提取提供基础。
保留表格结构与图文混排关系
复杂表格可能包含多级表头、合并单元格或跨页内容。如果只提取单元格文字,容易破坏字段与数值之间的对应关系,影响后续的数据提取。
对于这类表格,解析时需要保留行列关系及单元格的对应位置。TextIn xParse可通过include_table_structure配置输出表格行列、单元格位置及跨行跨列等结构信息,为后续表格还原和字段提取提供依据。
对于跨页表格,还可以通过element_merge_mode控制结果的组织方式:根据业务需求,分别输出各页表格片段,或将识别为同一逻辑表格的跨页内容合并处理,以适应逐页核查或完整表格处理等不同场景。
对于图文混排文档,图片、标题和正文之间的关联同样重要。例如,技术手册中的操作说明往往需要结合对应的示意图理解。通过结构化解析保留相关元素及其关联信息,有助于后续系统组织和处理图文内容,减少因元素关系丢失造成的信息割裂。
TextIn xParse支持通过include_hierarchy和include_inline_objects等配置获取元素层级及内嵌对象信息,并结合元素类型、坐标等数据,辅助组织图片、正文、公式等不同内容元素之间的关系。
保留页面元素与位置信息,支持原文定位与结果复核
对于复杂PDF,解析结果除了需要保留文本内容,还需要记录相关元素在原始文档中的位置,以便后续系统定位和调用。
TextIn xParse的JSON解析结果可提供元素类型、文本、页码及坐标等信息。借助这些结构化数据,开发者可以将解析内容与原始页面建立对应关系,在提取特定字段或调用文档内容时,定位相关信息的来源区域,为内容追溯和业务处理提供依据。
对于长文档,还可以通过title_tree配置获取标题层级及章节关系,辅助组织文档内容。结合元素信息与章节结构,系统能够更有序地组织解析结果,为后续的内容检索、信息提取和文档处理提供支持。
三、复杂文档结构化解析可以应用于哪些场景?
复杂文档转换为Markdown或JSON后,可以进一步用于企业知识库建设、业务文档自动化处理及AI Agent工作流。
企业知识库与RAG文档预处理。 将技术手册、制度文件和产品资料解析为结构化内容,再进行文本清洗、切片和索引构建,为后续检索和内容调用提供基础。
企业业务文档自动化处理。 对产品规格书、业务报告和订单附件等文件进行结构化解析,再结合字段提取、业务规则和系统接口完成信息整理,减少重复性的人工录入工作。
AI Agent文档处理工作流。 通过API调用TextIn xParse,将复杂文档转换为Markdown或JSON,再交由大模型或其他业务模块进行内容理解、信息提取和任务处理。
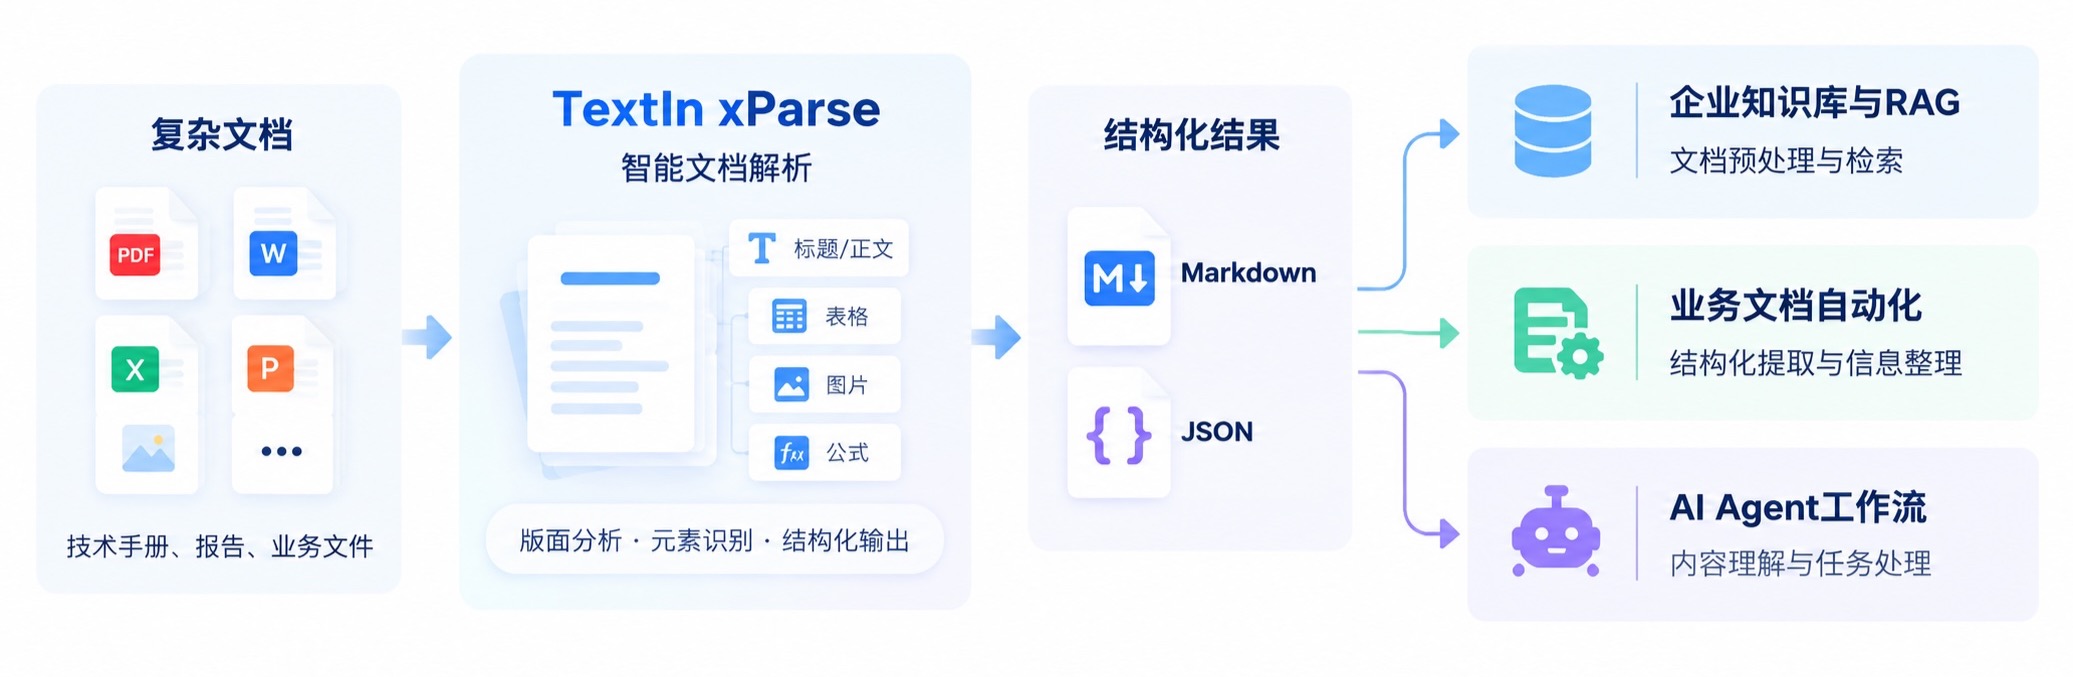
从批量文档接入、复杂版面识别到Markdown/JSON结构化输出,TextIn xParse为企业提供复杂文档解析与数据转换能力。开发者可以根据实际文档类型与业务需求,结合解析配置,保留原始文档中的内容结构,为知识库建设、业务自动化和AI应用提供可进一步处理的数据基础。